ПЛИС-декодеры реального времени (LCD, Deltaflow) dec_fpga
ПЛИС комнатной температуры, на которых работают декодеры кластеризации или паросочетания (matching), достаточно быстрые, чтобы разбирать синдромы поверхностного кода внутри цикла QEC, опережая альтернативы на GPU и криогенные.
ПЛИС-декодеры реального времени (LCD, Deltaflow)
Декодер локальной кластеризации (LCD) < 1 µs/раунд до d=17; контур реального времени Riverlane + Rigetti 9.6 µs (6.5 µs декодирование + 3.1 µs связь, патч стабильности 2×2, arXiv:2410.05202) против 63 µs у Google.
Обзор →Ключевые источники
Пространство проектирования — атрибуты
- (a) сродство носителя
- промежуточный / не зависящий от носителя
- (b) время · запутывание
- —
- (c) считывание
- —
- (d) подвижность
- —
- (e) управление
- —
- (f) структура ошибки
- стохастическая паулиевская
- (g) производство
- —
Пространство оценки — датированные атрибуты
Стандартные рекорды
Участники и цели — аннотации
Рёбра
Используют 1 машин (1 основная · 0 альтернатива)
- сверхпроводниковые схемы 1
- Rigetti Ankaa-2 Rigetti Computing статья статья ▣ Fig. 3c–d (FPGA decode time at 156.25 MHz); Fig. 4 (response time); Methods: FPGA decoder integration ✅
Иллюстрации
У каждой иллюстрации — рассказ о том, что на ней, и строка авторства.
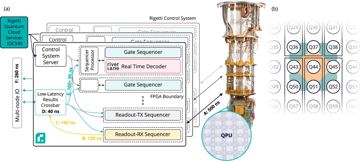
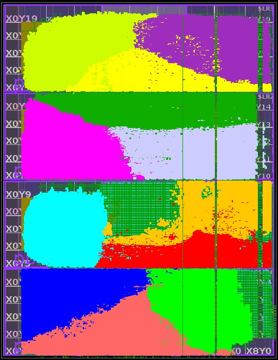
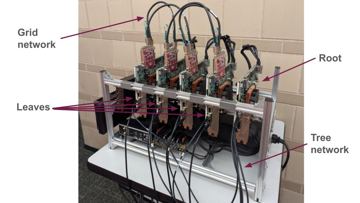
ПЛИС-декодеры реального времени (LCD, Deltaflow)
ПЛИС комнатной температуры, на которых работают декодеры кластеризации или паросочетания (matching), достаточно быстрые, чтобы разбирать синдромы поверхностного кода внутри цикла QEC, опережая альтернативы на GPU и криогенные.
Вердикт. Пропускная способность менее 1 µs на раунд опубликована вплоть до d=17, но декодирование живых синдромов поверхностного кода задокументировано лишь до d=5, а коррекция в замкнутом контуре — до d=3; отставание по точности от нейросетевых декодеров реально.
Λ — коэффициент подавления ошибок на один шаг кодового расстояния; QBI = DARPA Quantum Benchmarking Initiative (этап A — концепция → B — план НИОКР → C — государственная V&V); G1–G7 — классы целей отчёта (см. «Участники и экономика»).
Сущность и происхождение
Классическая аппаратура, потребляющая биты синдрома и выдающая коррекции внутри цикла кода. Происхождение — из аргумента о накоплении очереди: если среднее время декодирования превышает время цикла, недекодированные раунды копятся неограниченно, и логическую частоту ошибок начинает задавать классическая аппаратура. ПЛИС (FPGA) выиграли за счёт детерминированной задержки, а не скорости.
Атрибуты: вычислительный модуль, а не носитель (аффинность 0.5); собственных характерных времён, считывания, подвижности, управления и технологии изготовления нет.
Структура ошибок, которую он потребляет: паулиевские синдромы повёрнутого поверхностного кода.
Физика и пределы
Пропускная способность обязана разбирать один раунд за цикл — 1.1 µs на аппаратуре класса Willow D[1], — и декодер кластеризации Riverlane это обеспечивает вплоть до d=17 D[238]. Задержка реакции ограничивает каждый не-клиффордовский вентиль, и измерить её можно только в замкнутом контуре: в Shenzhen контур замкнули за 550 ns при d=3, внутри цикла 1.25 µs D[729]. За задержку платят точностью: порог LCD составляет 0.55% против 0.7% у программного MWPM D[238], а на одних и тех же синдромах Willow паросочетание дало Λ = 2.04 там, где нейросетевой декодер дал 2.14 D[1]. Вторая стена — площадь: LCD при d=17 занимает ~6% логических LUT кристалла Xilinx VU19P на один логический кубит D[238], то есть ~16 таких логических кубитов на одну микросхему верхнего уровня.
Достигнутый инженерный уровень
таблица
| Дата | Показатель | Кто | Тег |
|---|---|---|---|
| 2025-02-20 | Точный MWPM за 0.8 µs в среднем, d=13, p=0.1%, 62 MHz | Yale (Micro Blossom) | D[727] |
| 2025-12-17 | Кластеризация менее 1 µs на раунд вплоть до d=17 на одной ПЛИС | Riverlane | D[238] |
| 2026-05-06 | Первое нейросетевое декодирование на ПЛИС в замкнутом контуре на работающем процессоре, 550 ns при d=3 | IQA Shenzhen | D[729] |
Relay-BP от IBM для gross-кода заявляет итерацию 24 ns и менее 1 µs на цикл при p ниже 3×10⁻³ — на смоделированных синдромах S[48].
Показатели Relay-BP на ПЛИС у IBM получены на смоделированных синдромах, а приведённые в аннотации 24 ns / <1 µs противоречат значению 480 ns на окно из 12 циклов, приводимому в других источниках факт. Раунд серии C у Riverlane составляет $75 M в релизе 2024 года и $85 M в дорожной карте 2026 года. Сотрудничество IBM и AMD по декодеру на ПЛИС известно только из отраслевой прессы; его условия не опубликованы.
Производство, материалы и цепочка поставок
Собственного производства нет: коммерческая плата ПЛИС в стойке комнатной температуры. Каждый опубликованный декодер реального времени работает на кремнии AMD/Xilinx (VU19P для LCD D[238], VMK180 для Micro Blossom D[727]); единственная коммерческая альтернатива сменила владельца, когда продажа Intel 51% Altera фонду Silver Lake при оценке $8.75 B, объявленная в апреле 2025 года, была закрыта 2025-09-15 G[735], — дуополия, одна сторона которой находится под фондом прямых инвестиций. ПЛИС верхнего уровня попадают в периметр экспортного контроля США. Нагрузка по вводу-выводу — это канал синдромов: на 10³ кубитов она тривиальна, но на 10⁴–10⁶ его скорость вынуждает вводить предварительное декодирование при 4 K либо множество параллельных плат.
Роль в стеке
Альтернативный декодер на решётке трансмонов с перестраиваемыми элементами связи. Требует повёрнутого поверхностного кода и даёт поток коррекций, необходимый отказоустойчивости; он вытесняет декодирование на GPU, у которого хвостовая задержка недетерминирована — 3.84 µs в среднем и 3.96 µs максимум только на прохождение NVQLink C[324]. Его вклад в производный такт — это нижняя граница, а не слагаемое: он обязан укладываться в цикл 1.1 µs, и укладывается. Верификация: это показатели декодера в отрыве от системы, на воспроизведённых или смоделированных синдромах; живых контуров только два — при d=3 и с кластеризующим декодером в контуре на Rigetti Ankaa-2, единственном носителе по реестру; фигурирующие у Micro Blossom 367 ns — цифра из репозитория, не встречающаяся ни в одной статье, тогда как опубликованное значение равно 0.8 µs D[727].
Участники и экономика
Кто.
| Организация | Роль | Страна | Что именно делает с технологией | Свидетельство |
|---|---|---|---|---|
| Riverlane | поставщик | Великобритания | LCD и Deltaflow — единственный коммерческий стек QEC | D[238] |
| AMD | поставщик | США | Кремний ПЛИС, на котором работает каждый опубликованный декодер | D[238] |
| пользователь | США | Базовые 63 µs при d=5 D[1], затем нейросетевое декодирование при d=7 | D[2] | |
| IQA Shenzhen | исследования | Китай | Первое нейросетевое декодирование на ПЛИС в замкнутом контуре на работающем процессоре | D[729] |
Деньги.
2024-08-06 · Riverlane · раунд серии C · $75 M · лид Planet First Partners · закрыт C[661]факт
2025-09-15 · Intel/Altera · продажа 51% · оценка предприятия $8.75 B · Silver Lake · закрыто (объявлено 2025-04-14) G[735]факт
Рынок и цепочка поставок. Один коммерческий поставщик декодеров, один доминирующий поставщик ПЛИС и NVIDIA, продвигающая NVQLink как альтернативу, — открытая оконечная точка при ускорителе из единственного источника C[324]. Стек Riverlane поставляется интегрированным с управляющей аппаратурой Qblox C[659]. Он оплачивает только G3 и G4.
Интеллектуальная собственность и стандарты. Патент Riverlane GB 2641501 A «Quantum decoder» (опубликован 2025-12-10) заявляет сгруппированные обрабатывающие элементы, выполняющие кластеризацию на декодирующем гиперграфе, — то есть саму архитектуру LCD G[662]. Стандарта на декодеры не существует.
Дорожные карты и послужной список. Riverlane (2026-03-12 · megaquop до 2030, teraquop с 2033 · LCD опубликован в срок C[658]). IBM (2025-10 · декодирование gross-кода на ПЛИС · по состоянию на 2026-09-04 по-прежнему моделирование S[48]).
Стратегическое прочтение. Тот, кому принадлежит декодер, стоит между любым сверхпроводниковым QPU и отказоустойчивостью, — но слой достаточно тонок, чтобы поставщики QPU делали его собственными силами, как поступили IBM и Google. AMD выигрывает в любом случае; угроза в том, что NVQLink обезличит интерфейс до уровня биржевого товара.
Перспективы и открытые вопросы
Подтвердить к концу 2027: декодер на ПЛИС, замыкающий контур на живых синдромах при d ≥ 7, — живое декодирование при d = 7 не задокументировано ни для одного декодера, включая нейросетевой результат Google при d = 7 D[2], — либо Relay-BP на реальной аппаратуре gross-кода; понизить оценку, если не случится ни того ни другого. В лучшем случае к 2029 г.: переносимый интерфейс с кремнием от второго источника; в худшем — декодеры под каждого поставщика, которые невозможно сравнивать. Что связывает первым при d=17: задержка реакции или пропускная способность? Переживут ли поставщики декодеров переход поставщиков QPU на собственную разработку? Дотянется ли экспортный контроль до ПЛИС?
Литература
- [1] Google Quantum AI and Collaborators, “Quantum error correction below the surface code threshold,” Nature, vol. 638, no. 8052, pp. 920–926, Dec. 2024, doi: 10.1038/s41586-024-08449-y. [D]
- [2] V. Sivak et al., “Reinforcement learning control of quantum error correction,” Nature, vol. 655, no. 8124, pp. 879–884, Jul. 2026, doi: 10.1038/s41586-026-10759-2. [D]
- [48] T. Maurer et al., “Real-time decoding of the gross code memory with FPGAs,” arXiv:2510.21600, Oct. 2025. [S]
- [238] A. B. Ziad et al., “Local clustering decoder as a fast and adaptive hardware decoder for the surface code,” Nat. Commun., vol. 16, no. 1, Art. no. 11048, Dec. 2025, doi: 10.1038/s41467-025-66773-x. [D]
- [324] S. Caldwell et al., “NVIDIA NVQLink Architecture Integrates Accelerated Computing with Quantum Processors,” NVIDIA Technical Blog, Nov. 17, 2025. [Online]. Available: https://developer.nvidia.com/
blog/ [C]nvidia-nvqlink-architecture-integrates-accelerated-computing-with-quantum-processors/ - [658] Riverlane, “Riverlane publishes QEC Technology Roadmap that can accelerate quantum computing's path to utility scale by 3–5 years,” Mar. 12, 2026. [Online]. Available: https://www.riverlane.com/
press-release/ [C]riverlane-publishes-qec-technology-roadmap - [659] Qblox; Riverlane, “Qblox and Riverlane Demonstrate Integration Enabling Real-Time Quantum Error Correction,” PR Newswire, Mar. 17, 2026. [Online]. Available: https://www.prnewswire.com/
news-releases/ [C]qblox-and-riverlane-demonstrate-integration-enabling-real-time-quantum-error-correction-302716254.html - [661] Riverlane, “Riverlane raises $75 million to meet surging global demand for quantum error correction technology,” Aug. 6, 2024. [Online]. Available: https://www.riverlane.com/
press-release/ [C]riverlane-raises-75-million-to-meet-surging-global-demand-for-quantum-error-correction-technology - [662] A. B. Ziad, A. Zalawadiya, B. Barber, and L. Skoric, “Quantum decoder,” Google Patents, Dec. 10, 2025. [Online]. Available: https://patents.google.com/
patent/ [G]GB2641501A/ en - [727] Y. Wu, N. Liyanage, and L. Zhong, “Micro Blossom: Accelerated Minimum-Weight Perfect Matching Decoding for Quantum Error Correction,” Proc. 30th ACM Int. Conf. Architectural Support for Programming Languages and Operating Systems (ASPLOS '25), vol. 2, Mar. 2025, doi: 10.1145/3676641.3716005. arXiv:2502.14787. Also https://github.com/
yuewuo/ . [D]micro-blossom - [729] X. Yang et al., “Real-time Surface-Code Error Correction Using an FPGA-based Neural-Network Decoder,” arXiv:2605.04892, May 2026. Also https://arxiv.org/
html/ . [D]2605.04892 - [735] Altera, “Altera Closes Silver Lake Investment to Become World's Largest Pure-play FPGA Solutions Provider,” Sep. 15, 2025. [Online]. Available: https://www.altera.com/
newsroom/ [G]news/ press-release/ altera-silver-lake