RL-калибровка в контуре / подстройка управления dec_rl
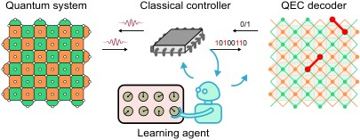
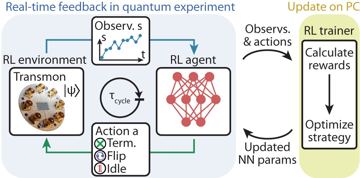
События детектирования от работающего кода одновременно служат сигналом вознаграждения для агента обучения с подкреплением, который перенастраивает параметры управления прямо по ходу QEC, заменяя плановую перекалибровку.
RL-калибровка в контуре / подстройка управления
Обучение с подкреплением подстраивает > 1 000 параметров управления во время QEC: ~20% дополнительного подавления, 3.5× устойчивость к дрейфу.
Обзор →Ключевые источники
Пространство проектирования — атрибуты
- (a) сродство носителя
- искусственный
- (b) время · запутывание
- —
- (c) считывание
- —
- (d) подвижность
- —
- (e) управление
- —
- (f) структура ошибки
- когерентная / калибровочная
- (g) производство
- —
Пространство оценки — датированные атрибуты
Стандартные рекорды
Участники и цели — аннотации
Рёбра
Используют 1 машин (0 основная · 1 альтернатива)
- сверхпроводниковые схемы 1
- Willow Google Quantum AI статья статья страница продукта ▤ ✅ (альтернатива)
Иллюстрации
У каждой иллюстрации — рассказ о том, что на ней, и строка авторства.
RL-калибровка в контуре / подстройка управления
События детектирования от работающего кода одновременно служат сигналом вознаграждения для агента обучения с подкреплением, который перенастраивает параметры управления прямо по ходу QEC, заменяя плановую перекалибровку.
Вердикт. Одна команда, один кристалл, одна работа; метод улучшает точечную ошибку при фиксированном расстоянии, и не показано, что он меняет Λ, — а именно это и требуется для рубежа 10⁻⁶.
Λ = коэффициент подавления ошибки на шаг кодового расстояния; QBI = DARPA Quantum Benchmarking Initiative (стадия A — концепция → B — план НИОКР → C — государственная верификация и валидация); G1–G7 = классы целей настоящего отчёта (см. «Участники и экономика»).
Сущность и происхождение
RL как оптимизатор управления сверхпроводниковыми кубитами не нов: широко цитируемый рекорд CZ в 99.92% между двумя флаксониумами, связанными через трансмон, — это оптимизированное с помощью RL среднее значение 99.922(9)% от 2023 года факт, но полученное офлайн и для одного вентиля. Sivak, Morvan, Broughton, Cortiñas et al. (Google, arXiv 2025-11-11; Nature 655, 2026-07-08) изменили сам контур: события детектирования служат одновременно синдромами и обучающим сигналом, так что калибровка идёт параллельно с вычислением [2].
a = 1.0, полностью инженерный слой классического управления, f = когерентная — метод гонится за систематическим дрейфом (двухуровневые системы (TLS), поток, температура), а не за стохастической ошибкой Паули [запись графа].
Физика и пределы
Нового физического предела нет: метод отслеживает существующий предел, но без мёртвого времени между калибровками. Несущее утверждение здесь архитектурное — скорость оптимизации не зависит от размера системы D[2], и это единственный путь в обход попараметрической развёртки, которая умирает выше ~10³ регулировок. Пределы следуют из того, что агент видит и что подстраивает: усреднённую частоту событий детектирования и только параметры однокубитных вентилей и вентилей CZ D[2]. Примерно ежечасные коррелированные всплески на Willow события детектирования порождают, но затухают за ~400 µs D[1] — гораздо быстрее, чем агент успевает отреагировать, и такой быстрый коррелированный дрейф статья оставляет аппаратному подавлению D[2]. Утечка (leakage) из вычислительного пространства, которую Willow убирает отдельным шагом после каждого раунда D[1], в статье не рассматривается, а считывание на уровне ~10⁻² не входит в число подстраиваемых параметров. Показатель степени метод не меняет: для рекордного прогона с d=7 значение Λ не приводится, так что сдвинулась точечная ошибка при фиксированном расстоянии, а не тот наклон, который решает, дотянет ли d≈25 до 10⁻⁶.
Исходную посылку перекалибровки в контуре оспаривает измерение 2026 года: долгоживущие двухуровневые системы (TLS) на трансмоне придают окружению память от 20 µs до 1 ms — сотни циклов коррекции ошибок по ~1 µs, — так что ошибки начинают зависеть от предыстории и от протокола; авторы противопоставляют это марковскому (без памяти) допущению, на котором стоит непрерывная калибровка P[890].
Достигнутый инженерный уровень
таблица
| Дата | Показатель | Кто | Тег+ключ |
|---|---|---|---|
| 2026-07-08 | Поверхностный код d=7, декодирование AlphaQubit2 (живое декодирование не заявлено): 7.72(9)×10⁻⁴ за цикл; Λ не приводится | Google Quantum AI | D[2]факт |
| 2026-07-08 | Цветовой код d=5, декодер Tesseract: 8.19(14)×10⁻³ за цикл; устойчивость 3.5× к внесённому дрейфу | Google Quantum AI | D[2] |
| 2024-12-09 | Λ = 2.14(2) с нейросетевым декодером против 2.04(2) с ансамблевым паросочетанием (matching) на идентичных синдромах Willow | Google Quantum AI | D[1]факт |
Собственные бенчмарки реального времени AlphaQubit 2 (arXiv:2512.07737) выполнены на записанных данных, а статья об обучении с подкреплением не утверждает, что декодирование её прогона при d=7 шло в реальном времени.
Производство, материалы и цепочка поставок
Выделенного кремния нет и, в отличие от декодеров на паросочетании или кластеризации, нет заявленного расхода ресурсов ПЛИС (FPGA), который можно было бы проверить факт. Стоимость — это трафик плоскости управления: события детектирования наружу, обновления параметров внутрь, по собственному каналу декодера; вендор-нейтральной версией этого служит время кругового обхода NVQLink — 3.84 µs в среднем и 3.96 µs максимум Cфакт. Обновления идут на медленной временной шкале, вне цикла 1.1 µs, — именно поэтому метод уживается с Willow там, где более тяжёлые вычисления в контуре не ужились бы. Поставки — это мощности GPU/TPU плюс стек управления; отдельного правила экспортного контроля нет.
Роль в стеке
Декодера внутри контура управления не требует: вознаграждение — частота событий детекции; управление декодером перевзвешивает граф паросочетаний по оценкам логической ошибки, не в реальном времени, а рекордный прогон с d=7 декодировался отдельно нейросетевым декодером AlphaQubit2, отдельно описанным лишь в препринте декабря 2025 г., где скорость реального времени измерена на записанных или смоделированных данных D[2]факт. Только сверхпроводниковые трансмоны; производный раунд не меняется и равен 0.65 µs против измеренного цикла QEC 1.1 µs, ~0.91 MHz. Верификация: для рекордного прогона Λ нет, воспроизведения на второй платформе нет, а единственное живое нейросетевое декодирование в замкнутом контуре где бы то ни было — это демонстрация с d=3 и контуром 550 ns D[729]. Конфликта значений нет: 20% и >1 000 параметров в отраслевой прессе P[742] — цифры самой статьи (примерно на 20% более сильное подавление логической ошибки после обычной калибровки, более тысячи подстраиваемых параметров), наряду с её выигрышем 3.5× в устойчивости к внесённому дрейфу D[2].
Участники и экономика
Кто.
| Организация | Роль | Страна | Что именно | Свидетельство |
|---|---|---|---|---|
| Google Quantum AI | разработчик | США | Управление на RL, AlphaQubit2, Willow | D[2] |
| Google DeepMind | разработчик | Великобритания | Нейросетевые декодеры, линия AlphaQubit | D[657] |
| Q-CTRL | поставщик | Австралия | Калибровочное ПО Boulder Opal | C[743] |
| IQA Shenzhen | исследования | Китай | Единственное живое нейросетевое декодирование в замкнутом контуре | D[729] |
Деньги.
2024-10-08 · Q-CTRL · расширенный раунд серии B · USD $113 M (AUD $166 M) · ведущий инвестор GP Bullhound · закрыт C[743]
2025-10-03 · Google Quantum AI · поглотила Atlantic Quantum, управление на холодной ступени · сумма не раскрыта Pфакт
2025-11-06 · DARPA QBI Stage B · IBM — единственный трансмонный вендор, Google отсутствует · ≤$15 M каждому факт
Рынок и цепочка поставок. Рынка компонентов нет; оцениваемый заменитель — калибровочное ПО плюс такты GPU/TPU, которые продаёт только Q-CTRL, на платформах Diraq, Oxford Quantum Circuits и Rigetti C[743]. Платит по G3/G4.
Интеллектуальная собственность и стандарты. Датированного патентного семейства по калибровке QEC под управлением RL по состоянию на 4 сентября 2026 г. нет; Google публикует метод и придерживает декодер — вот где защитный ров.
Дорожные карты и послужной список. Следующий рубеж Google, долгоживущий логический кубит на уровне 10⁻⁶ (без даты): 7.72×10⁻⁴ при d=7 отстоит от него на три порядка и требует d≈25 при Λ≈2 D[1]; в QBI Stage B Google отсутствует G. Q-CTRL поставила Boulder Opal на трёх платформах к 2024-10 — выполнено, но в масштабе, несопоставимом с гугловским.
Стратегическое прочтение. Программная маржа на железе, которым владеет кто-то другой. Если метод разойдётся, его заберут вендоры систем управления и Q-CTRL, а штат калибровщиков сократится; если AlphaQubit2 останется внутренним инструментом Google, преимуществом Google будет декодер, а не RL. Угроза замещения: железо, которое меньше дрейфует, — флаксониум, управление на быстрой одноквантовой логике (БОК) на холодной ступени — уменьшает саму задачу.
Перспективы и открытые вопросы
Подтвердить, если калибровка с RL в контуре появится на второй платформе либо будет опубликовано Λ для прогона под управлением RL; понизить в статусе, если она останется привязанной только к Willow. В лучшем случае к 2029 году: стандарт во всех сверхпроводниковых отказоустойчивых стеках, продаваемый вендорами систем управления. В худшем случае: один невоспроизведённый кристалл. Открыто: переживает ли независимая от размера оптимизация выход за пределы моделирования и можно ли сделать контур независимым от декодера?
Литература
- [1] Google Quantum AI and Collaborators, “Quantum error correction below the surface code threshold,” Nature, vol. 638, no. 8052, pp. 920–926, Dec. 2024, doi: 10.1038/s41586-024-08449-y. [D]
- [2] V. Sivak et al., “Reinforcement learning control of quantum error correction,” Nature, vol. 655, no. 8124, pp. 879–884, Jul. 2026, doi: 10.1038/s41586-026-10759-2. [D]
- [657] J. Bausch et al., “Learning high-accuracy error decoding for quantum processors,” Nature, vol. 635, no. 8040, pp. 834–840, Nov. 2024, doi: 10.1038/s41586-024-08148-8. [D]
- [729] X. Yang et al., “Real-time Surface-Code Error Correction Using an FPGA-based Neural-Network Decoder,” arXiv:2605.04892, May 2026. Also https://arxiv.org/
html/ . [D]2605.04892 - [742] J. Burt, “Google Uses AI Reinforcement Learning For Quantum Error Correction,” The Next Platform, Jul. 20, 2026. [Online]. Available: https://www.nextplatform.com/
compute/ [P]2026/ 07/ 20/ google-uses-ai-reinforcement-learning-for-quantum-error-correction/ 5275023 - [743] Q-CTRL, “Q-CTRL Sets Global Quantum Technology Fundraising Record, Increasing Series B to USD $113M, Led by GP Bullhound,” Oct. 8, 2024. [Online]. Available: https://q-ctrl.com/
blog/ [C]q-ctrl-sets-global-quantum-technology-fundraising-record-increasing-series-b-to-usd-113m-led-by-gp-bullhound - [890] J. R. Guimarães et al., “Quantum environment afterglow from broadband excitation spectroscopy in superconducting qubits,” arXiv:2609.31280, Sep. 2026. [P]
G AlphaQubit2 is named and described as "a scalable and real-time neural decoder for topological quantum codes" in Sivak, Morvan, Broughton et al. (Google Quantum AI), "Reinforcement… · 2026-07-08 · https://link.springer.com/article/10.1038/s41586-026-10759-2
G Google Quantum AI, "Quantum error correction below the surface code threshold" (Nature 638, 920; arXiv:2408.13687): the real-time decoder for the distance-5 10^6-cycle run is a spe… · 2024-12-09 · https://arxiv.org/abs/2408.13687
G Ding, Hays, Sung, ... Serniak, Oliver (MIT / MIT Lincoln Laboratory), Phys. Rev. X 13, 031035 (2023-09-25): fluxonium CZ with transmon coupler, peak CZ fidelities 99.85-99.9%, rein… · 2023-09-25 · https://journals.aps.org/prx/abstract/10.1103/PhysRevX.13.031035
G Ziad, Zalawadiya, Topal, Camps, Gehér, Stafford, Turner (Riverlane), "Local clustering decoder as a fast and adaptive hardware decoder for the surface code", Nature Communications… · 2025-12-17 · https://www.nature.com/articles/s41467-025-66773-x
G NVIDIA developer blog (2025-11-17) detail: RoCE round trip 3.84 us mean, 0.035 us standard deviation, 3.96 us MAXIMUM over 1 000 samples (a bounded tail, not just a mean); BP+OSD o… · 2025-11-17 · https://developer.nvidia.com/blog/nvidia-nvqlink-architecture-integrates-accelerated-computing-with-quantum-processors/
G Atlantic Quantum (fluxonium, cold-stage control) joined Google Quantum AI, 2025-10-03 · 2025-10-03 · https://thequantuminsider.com/2025/10/03/atlantic-quantum-joins-google-quantum-ai/
G DARPA QBI Stage B (announced 2025-11-06, ~12 months, up to $15 M each): Atom Computing, Diraq, IBM, IonQ, Nord Quantique, Photonic Inc., Quantinuum, Quantum Motion, QuEra, Silicon… · 2025-11-06 · https://www.darpa.mil/research/programs/quantum-benchmarking-initiative/stage-b-selection