כיול RL בלולאה / היגוי הבקרה dec_rl
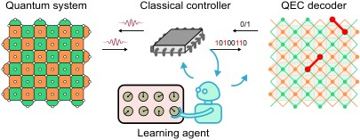
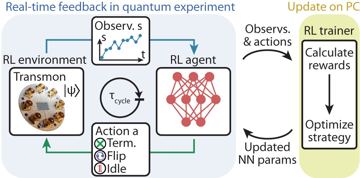
אירועי הגילוי של הקוד הרץ משמשים גם כאות התגמול של סוכן למידת חיזוק, המכוונן מחדש את פרמטרי הבקרה במהלך תיקון השגיאות ומחליף את הכיול מחדש לפי לוח זמנים.
כיול RL בלולאה / היגוי הבקרה
למידת חיזוק מכווננת > 1,000 פרמטרי בקרה במהלך תיקון השגיאות: ~20% דיכוי נוסף, עמידות גבוהה 3.5× לסחיפה.
תקציר ←מקורות מרכזיים
מרחב התכן — תכונות
- (a) זיקת הנושא
- מיוצר
- (b) זמן · שזירה
- —
- (c) קריאה
- —
- (d) ניידות
- —
- (e) בקרה
- —
- (f) מבנה השגיאה
- קוהרנטית / כיול
- (g) ייצור
- —
מרחב ההערכה — תכונות מתוארכות
רשומות סטנדרטיות
שחקנים ויעדים — ביאורים
קשתות
תמונות
כל תמונה מלווה בתיאור של מה שהיא מראה ובשורת הקרדיט שלה.
כיול RL בלולאה / היגוי הבקרה
אירועי הגילוי של הקוד הרץ משמשים גם כאות התגמול של סוכן למידת חיזוק, המכוונן מחדש את פרמטרי הבקרה במהלך תיקון השגיאות ומחליף את הכיול מחדש לפי לוח זמנים.
Verdict. צוות אחד, שבב אחד, מאמר אחד; השיטה משפרת את השגיאה הנקודתית במרחק קבוע, ולא הוכח שהיא משנה את Λ, ובו בדיוק תלויה אבן הדרך של 10⁻⁶.
Λ = מקדם דיכוי השגיאות לכל צעד במרחק הקוד; QBI = DARPA Quantum Benchmarking Initiative (שלב A — רעיון → B — תוכנית מו״פ → C — אימות ותיקוף (V&V) ממשלתיים); G1–G7 = מחלקות היעדים של הדוח (ראו "שחקנים וכלכלה").
זהות ומוצא
למידת חיזוק (RL) ככלי לאופטימיזציה של בקרה בקיוביטים מוליכי-על אינה חדשה: שיא ה-CZ של 99.92% בין שני קיוביטי פלוקסוניום המצומדים דרך טרנסמון, המצוטט לעתים קרובות, הוא ממוצע של 99.922(9)% שעבר אופטימיזציה ב-RL, מ-2023 fact, אבל במצב לא מקוון ולכל שער בנפרד. Sivak, Morvan, Broughton, Cortiñas et al. (Google, arXiv 2025-11-11; Nature 655, 2026-07-08) שינו את הלולאה: אירועי הגילוי משמשים גם כסינדרומים וגם כאות למידה, ולכן הכיול רץ במקביל לחישוב [2].
a = 1.0, שכבת בקרה קלאסית מהונדסת כולה; f = קוהרנטית — השיטה רודפת אחר סחיפה שיטתית של מערכות דו-רמתיות (TLS), של השטף ושל הטמפרטורה, ולא אחר שגיאת פאולי סטוכסטית [graph].
פיזיקה וגבולות
אין רצפה פיזיקלית חדשה: השיטה עוקבת אחר רצפה קיימת, בלי הזמן המת שבין כיולים. הטענה הנושאת את המשקל היא ארכיטקטונית — מהירות האופטימיזציה אינה תלויה בגודל המערכת D[2], וזו הדרך היחידה לעקוף את הסריקה פרמטר-אחר-פרמטר, הקורסת מעל ~10³ פרמטרים ברי-כוונון. המגבלות נובעות ממה שהסוכן רואה וממה שהוא מכוונן: קצב ממוצע של אירועי גילוי, ופרמטרים של שערים חד-קיוביטיים ושל שערי CZ בלבד D[2]. הפרצים המתואמים של Willow, המופיעים בערך פעם בשעה, אכן מייצרים אירועי גילוי, אך דועכים בתוך ~400 µs D[1] — מהר בהרבה ממה שהסוכן מסוגל להגיב — והמאמר מותיר סחיפה מתואמת מהירה כזו לטיפול ברמת החומרה D[2]. דליפה אל מחוץ למרחב החישובי, ש-Willow מסלק בשלב הסרה ייעודי אחרי כל סבב D[1], אינה נידונה במאמר, ושגיאת הקריאה, ברמה של ~10⁻², אינה בין הפרמטרים המכווננים. השיטה אינה משנה את המעריך: לא דווח Λ לריצת השיא ב-d=7, ולכן מה שזז הוא השגיאה הנקודתית במרחק קבוע, ולא השיפוע שקובע אם d≈25 יגיע ל-10⁻⁶.
ההנחה שביסוד הכיול מחדש בלולאה מוטלת בספק בידי מדידה מ-2026: מערכות דו-רמתיות (TLS) ארוכות-חיים על טרנסמון מעניקות לסביבה זיכרון של 20 µs עד 1 ms — מאות מחזורי תיקון שגיאות של ~1 µs — ולכן השגיאות נעשות תלויות בהיסטוריה ובפרוטוקול, והמחברים מעמידים זאת מול ההנחה המרקובית (חסרת הזיכרון) שביסוד הכיול הרציף P[890].
מצב ההנדסה העדכני
טבלה
| תאריך | נתון | מי | תג+מפתח |
|---|---|---|---|
| 2026-07-08 | קוד המשטח ב-d=7, פענוח ב-AlphaQubit2 (לא צוין פענוח חי): 7.72(9)×10⁻⁴ למחזור; לא דווח Λ | Google Quantum AI | D[2]fact |
| 2026-07-08 | קוד הצבע ב-d=5, מפענח Tesseract: 8.19(14)×10⁻³ למחזור; יציבות גבוהה 3.5× מול סחיפה מוזרקת | Google Quantum AI | D[2] |
| 2024-12-09 | Λ = 2.14(2) עם המפענח המבוסס על רשת עצבית לעומת 2.04(2) עם אנסמבל של מפענחי זיווג, על אותם סינדרומים של Willow | Google Quantum AI | D[1]fact |
מבחני זמן האמת של AlphaQubit 2 עצמו (arXiv:2512.07737) רצו על נתונים מוקלטים, והמאמר על למידת החיזוק אינו מציין שהפענוח של הריצה שלו ב-d=7 רץ בזמן אמת.
ייצור, חומרים ושרשרת האספקה
אין צורן ייעודי, ובניגוד למפענחי זיווג או אשכול, אין טענה על צריכת משאבי FPGA שאפשר לבדוק fact. העלות היא תעבורה במישור הבקרה — אירועי גילוי יוצאים ועדכוני פרמטרים נכנסים, דרך הקישור של המפענח עצמו; זמן ההלוך-ושוב של NVQLink, 3.84 µs בממוצע ו-3.96 µs לכל היותר, הוא הגרסה של קישור כזה שאינה תלויה בספק Cfact. העדכונים רצים בסקלת זמן איטית, מחוץ למחזור של 1.1 µs, ולכן השיטה מתקיימת לצד Willow, שבו חישוב כבד יותר בתוך הלולאה לא היה מתקיים. האספקה היא קיבולת GPU/TPU ועוד מחסנית הבקרה; אין כלל יצוא ייעודי.
תפקיד במחסנית
אינו דורש מפענח בתוך לולאת הבקרה — התגמול הוא שיעור אירועי הגילוי; היגוי המפענח משנה את משקלות גרף הזיווג לפי הערכות של השגיאה הלוגית, שלא בזמן אמת, וריצת השיא ב-d=7 פוענחה בנפרד במפענח AlphaQubit2 המבוסס על רשת עצבית, שפורסם בנפרד רק כקדם-פרסום מדצמבר 2025, ובו נמדדה מהירות הפענוח בזמן אמת על נתונים מוקלטים או מדומים D[2]fact. טרנסמונים מוליכי-על בלבד; הסבב הנגזר נשאר 0.65 µs, לעומת מחזור תיקון השגיאות הנמדד של 1.1 µs, ~0.91 MHz. אימות: אין Λ לריצת השיא, אין שחזור בפלטפורמה שנייה, והפענוח החי היחיד המבוסס על רשת עצבית בלולאה סגורה, בכל מקום שהוא, הוא הדגמה ב-d=3 עם לולאה של 550 ns D[729]. אין סתירת ערכים: הנתון 20% והנתון >1,000 פרמטרים שבעיתונות המקצועית P[742] הם נתוני המאמר עצמו — כ-20% דיכוי נוסף של השגיאה הלוגית אחרי כיול רגיל, ויותר מאלף פרמטרים מכווננים — לצד שיפור של 3.5× ביציבות מול סחיפה מוזרקת D[2].
שחקנים וכלכלה
מי.
| ארגון | תפקיד | מדינה | מה בדיוק | ראיות |
|---|---|---|---|---|
| Google Quantum AI | מפתח | ארה״ב | בקרה בלמידת חיזוק, AlphaQubit2, Willow | D[2] |
| Google DeepMind | מפתח | בריטניה | מפענחים מבוססי רשתות עצביות, סדרת AlphaQubit | D[657] |
| Q-CTRL | ספק | אוסטרליה | תוכנת הכיול Boulder Opal | C[743] |
| IQA Shenzhen | מחקר | סין | הפענוח החי היחיד המבוסס על רשת עצבית בלולאה סגורה | D[729] |
כספים.
2024-10-08 · Q-CTRL · הרחבת סבב B · USD $113 M (AUD $166 M) · בהובלת GP Bullhound · נסגר C[743]
2025-10-03 · Google Quantum AI · קלטה את Atlantic Quantum ואת הבקרה שלה בשלב הקר · לא נמסר Pfact
2025-11-06 · DARPA QBI שלב B · IBM היא ספקית הטרנסמונים היחידה, Google נעדרת · ≤$15 M לכל אחד fact
שוק ושרשרת אספקה. אין שוק רכיבים; התחליף שיש לו מחיר הוא תוכנת כיול ועוד מחזורי GPU/TPU, והוא נמכר רק בידי Q-CTRL, לשימוש על החומרה של Diraq, Oxford Quantum Circuits ו-Rigetti C[743]. משלמים עליו G3/G4.
קניין רוחני ותקנים. נכון ל-4 בספטמבר 2026 אין משפחת פטנטים מתוארכת לכיול תיקון שגיאות בהיגוי RL; Google מפרסמת את השיטה ושומרת לעצמה את המפענח — זה החפיר התחרותי.
מפות דרכים ועמידה בהבטחות. אבן הדרך הבאה של Google, קיוביט לוגי ארוך-חיים ב-10⁻⁶ (ללא תאריך): 7.72×10⁻⁴ ב-d=7 רחוק ממנה בשלושה סדרי גודל, וסגירת הפער דורשת d≈25 ב-Λ≈2 D[1]; Google נעדרת משלב B של QBI G. Q-CTRL סיפקה את Boulder Opal בשלוש פלטפורמות עד 2024-10 — סופק, בקנה מידה רחוק מאוד מזה של Google.
פרשנות אסטרטגית. שולי רווח של תוכנה על חומרה שבבעלות אחרים. אם השיטה תתפשט, את שולי הרווח יקטפו ספקי הבקרה ו-Q-CTRL, ומספר העובדים בכיול ירד; אם AlphaQubit2 יישאר כלי פנימי של Google, היתרון של Google הוא המפענח, לא ה-RL. איום תחליף: חומרה שנסחפת פחות — פלוקסוניום, בקרת SFQ בשלב הקר — מכווצת את הבעיה.
תחזית ושאלות פתוחות
לאשר אם כיול RL בלולאה יופיע בפלטפורמה שנייה, או אם יפורסם Λ לריצה בהיגוי RL; להוריד בדרגה אם יישאר מוגבל ל-Willow. התרחיש הטוב ביותר ל-2029: תקן בכל מחסניות מוליכי-העל הסובלניות לתקלות, הנמכר בידי ספקי הבקרה. התרחיש הגרוע ביותר: שבב אחד שלא שוחזר. פתוח: האם אופטימיזציה שאינה תלויה בגודל שורדת מחוץ לסימולציה, והאם אפשר להפוך את הלולאה לבלתי תלויה במפענח?
מקורות
- [1] Google Quantum AI and Collaborators, “Quantum error correction below the surface code threshold,” Nature, vol. 638, no. 8052, pp. 920–926, Dec. 2024, doi: 10.1038/s41586-024-08449-y. [D]
- [2] V. Sivak et al., “Reinforcement learning control of quantum error correction,” Nature, vol. 655, no. 8124, pp. 879–884, Jul. 2026, doi: 10.1038/s41586-026-10759-2. [D]
- [657] J. Bausch et al., “Learning high-accuracy error decoding for quantum processors,” Nature, vol. 635, no. 8040, pp. 834–840, Nov. 2024, doi: 10.1038/s41586-024-08148-8. [D]
- [729] X. Yang et al., “Real-time Surface-Code Error Correction Using an FPGA-based Neural-Network Decoder,” arXiv:2605.04892, May 2026. Also https://arxiv.org/
html/ . [D]2605.04892 - [742] J. Burt, “Google Uses AI Reinforcement Learning For Quantum Error Correction,” The Next Platform, Jul. 20, 2026. [Online]. Available: https://www.nextplatform.com/
compute/ [P]2026/ 07/ 20/ google-uses-ai-reinforcement-learning-for-quantum-error-correction/ 5275023 - [743] Q-CTRL, “Q-CTRL Sets Global Quantum Technology Fundraising Record, Increasing Series B to USD $113M, Led by GP Bullhound,” Oct. 8, 2024. [Online]. Available: https://q-ctrl.com/
blog/ [C]q-ctrl-sets-global-quantum-technology-fundraising-record-increasing-series-b-to-usd-113m-led-by-gp-bullhound - [890] J. R. Guimarães et al., “Quantum environment afterglow from broadband excitation spectroscopy in superconducting qubits,” arXiv:2609.31280, Sep. 2026. [P]
G AlphaQubit2 is named and described as "a scalable and real-time neural decoder for topological quantum codes" in Sivak, Morvan, Broughton et al. (Google Quantum AI), "Reinforcement… · 2026-07-08 · https://link.springer.com/article/10.1038/s41586-026-10759-2
G Google Quantum AI, "Quantum error correction below the surface code threshold" (Nature 638, 920; arXiv:2408.13687): the real-time decoder for the distance-5 10^6-cycle run is a spe… · 2024-12-09 · https://arxiv.org/abs/2408.13687
G Ding, Hays, Sung, ... Serniak, Oliver (MIT / MIT Lincoln Laboratory), Phys. Rev. X 13, 031035 (2023-09-25): fluxonium CZ with transmon coupler, peak CZ fidelities 99.85-99.9%, rein… · 2023-09-25 · https://journals.aps.org/prx/abstract/10.1103/PhysRevX.13.031035
G Ziad, Zalawadiya, Topal, Camps, Gehér, Stafford, Turner (Riverlane), "Local clustering decoder as a fast and adaptive hardware decoder for the surface code", Nature Communications… · 2025-12-17 · https://www.nature.com/articles/s41467-025-66773-x
G NVIDIA developer blog (2025-11-17) detail: RoCE round trip 3.84 us mean, 0.035 us standard deviation, 3.96 us MAXIMUM over 1,000 samples (a bounded tail, not just a mean); BP+OSD o… · 2025-11-17 · https://developer.nvidia.com/blog/nvidia-nvqlink-architecture-integrates-accelerated-computing-with-quantum-processors/
G Atlantic Quantum (fluxonium, cold-stage control) joined Google Quantum AI, 2025-10-03 · 2025-10-03 · https://thequantuminsider.com/2025/10/03/atlantic-quantum-joins-google-quantum-ai/
G DARPA QBI Stage B (announced 2025-11-06, ~12 months, up to $15 M each): Atom Computing, Diraq, IBM, IonQ, Nord Quantique, Photonic Inc., Quantinuum, Quantum Motion, QuEra, Silicon… · 2025-11-06 · https://www.darpa.mil/research/programs/quantum-benchmarking-initiative/stage-b-selection