מפענחים מבוססי רשתות עצביות (AlphaQubit 2, CNN, טרנספורמרים) dec_nn
מפענחי סינדרום נלמדים — טרנספורמרים חוזרים, רשתות CNN, רשתות LSTM, מודלי מרחב-מצבים — הגוברים על הזיווג בכך שהם לומדים מהנתונים את רעש ההתקן שאינו רעש פאולי.
מפענחים מבוססי רשתות עצביות (AlphaQubit 2, CNN, טרנספורמרים)
מפענחים נלמדים עושים ~6% פחות שגיאות ממפענח רשת טנזורים ו-~30% פחות מזיווג מתואם על נתוני Sycamore, ו-20–29% פחות מזיווג בסימולציה עד d=11; פענוח מבוסס רשת עצבית ב-FPGA ב-124 ns ב-d=3; תפוקה מהירה מ-1 µs למחזור הודגמה עד d=11, על נתונים מוקלטים או מדומים, לא בפעולה חיה.
תקציר ←מקורות מרכזיים
מרחב התכן — תכונות
- (a) זיקת הנושא
- ביניים / בלתי תלוי בנושא
- (b) זמן · שזירה
- —
- (c) קריאה
- —
- (d) ניידות
- —
- (e) בקרה
- —
- (f) מבנה השגיאה
- פאולי סטוכסטית
- (g) ייצור
- —
מרחב ההערכה — תכונות מתוארכות
רשומות סטנדרטיות
שחקנים ויעדים — ביאורים
קשתות
בשימוש: 7 מכונות (4 ראשית · 3 חלופית)
- מעגלים מוליכי-על 3
- Zuchongzhi 3.2 USTC / Hefei National Laboratory ▣ Fig. 2d, 3c (decoded fidelities); main text: neural-network decoder ✅
- Sycamore-class 72-qubit processor Google Quantum AI מאמר מאמר ▤ 🔎 (חלופית)
- Willow Google Quantum AI מאמר מאמר דף מוצר ▤ ✅ (חלופית)
- אטומים ניטרליים 4
- Infleqtion Illinois neutral-atom quantum computer (IQMP, Chicago) Infleqtion עיתונות ◌ 🔎
- Sqale Infleqtion עיתונות ▨ ✅
- Quantum X Labs neutral-atom platform (50+ qubits, claimed) Quantum X Labs Inc. (Nasdaq: QXL) עיתונות קישור ▨ 🔎
- 448-atom fault-tolerant processor Harvard / MIT / QuEra מאמר עיתונות ▣ Fig. 2 (logical error per round: machine learning with/without loss information) ✅ (חלופית)
תמונות
כל תמונה מלווה בתיאור של מה שהיא מראה ובשורת הקרדיט שלה.
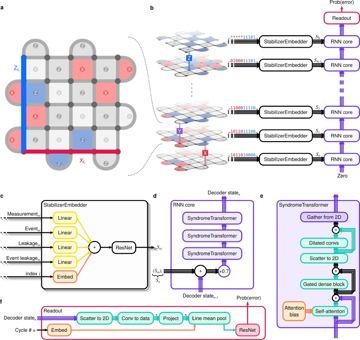
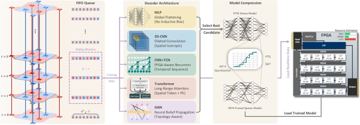
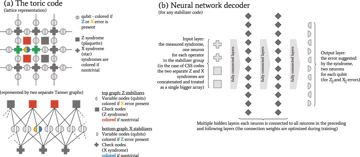
מפענחים מבוססי רשתות עצביות (AlphaQubit 2, CNN, טרנספורמרים)
מפענחי סינדרום נלמדים — טרנספורמרים חוזרים, רשתות CNN, רשתות LSTM, מודלי מרחב-מצבים — הגוברים על הזיווג בכך שהם לומדים מהנתונים את רעש ההתקן שאינו רעש פאולי.
Verdict. יתרון הדיוק ממשי, אך מהירות של זמן אמת הודגמה רק על נתונים מוקלטים או מדומים, עד מרחק 11, ובפעולה חיה רק במרחק 3; השאלה הפתוחה היא אם היתרון ישרוד תפוקה וסחיפה בפעולה חיה מעבר למרחק 11.
Λ = מקדם דיכוי השגיאות לכל צעד במרחק הקוד; QBI = DARPA Quantum Benchmarking Initiative (שלב A — רעיון → B — תוכנית מו״פ → C — אימות ותיקוף (V&V) ממשלתיים); G1–G7 = מחלקות היעדים של הדוח (ראו "שחקנים וכלכלה").
זהות ומוצא
מפענח מבוסס רשת עצבית מחליף את שלב ההסקה הקומבינטורי של תיקון השגיאות במקרב פונקציות מאומן: היסטוריית הסינדרומים נכנסת, התיקון הלוגי יוצא. פענוח הוא הסקה בייסיאנית על היפר-גרף של שגיאות-גלאים, וזיווג מושלם במשקל מינימלי מדויק רק כאשר ההיפר-גרף הזה דמוי-גרף — כל שגיאה מהפכת לכל היותר שני גלאים, בהסתברויות בלתי תלויות, ידועות וקבועות. התקנים אמיתיים מפרים את שלושת התנאים: דליפה מוציאה קיוביט מתת-המרחב החישובי ומשאירה אותו מחוצה לו לאורך סבבים רבים, פרצים מתואמים קושרים גלאים מרוחקים, הקריאה אנלוגית לפני הפעלת הסף, והרעש נסחף. מפענח נלמד משערך במקום זאת את ההתפלגות המשותפת מנתונים מתויגים, וצורך קריאה רכה (soft readout) ודגלי דליפה שהזיווג אינו יכול לייצג. המוצא נמשך ממפענחי קונבולוציה (2017) אל AlphaQubit, טרנספורמר חוזר (recurrent) שפרסמה Google DeepMind עם Google Quantum AI ב-2024-11-20 D[657]fact, ואל AlphaQubit2, שמאמר Willow מיולי 2026 מכנה "מפענח מבוסס רשת עצבית ניתן להרחבה ובזמן אמת לקודים קוונטיים טופולוגיים" D[2].
תכונות: זיקה לנושא 0.5, ואין לו נושא משלו; אין זמן אופייני או פעולת שזירה, והוא יורש את זמן מחזור הסינדרום של המארח (1.1 µs ב-Willow D[1]fact); אין קריאה, אף שהוא צורך את הערכים הרכים שהזיווג משליך; אין ניידות מעבר לגרף שגיאות-הגלאים שעליו אומן; אין אופן בקרה — המיקום הוא המשתנה: לוגיקה בטמפרטורת החדר כיום, צורן קר בהצעה; מבנה שגיאה פאולי, וערכו בשארית שאינה פאולי; אין ייצור משלו.
פיזיקה וגבולות
הרצפה נקבעת בידי תורת המידע ובידי החישוב, לא בידי הפיזיקה: התקרה היא פענוח סבירות מרבית, והזיווג נמצא מתחתיה בפער מדיד. על נתוני Sycamore הגיע AlphaQubit ל-2.748(15)×10⁻² שגיאה לוגית לסבב במרחק 5, לעומת 2.915(16)×10⁻² במפענח רשתות הטנזורים — מפענח המקרב סבירות מרבית — ול-2.901(23)×10⁻² לעומת 3.028(23)×10⁻² במרחק 3: כ-6% וכ-4% פחות שגיאות D[657]; לעומת זיווג מתואם במרחק 5 היו לו כ-30% פחות שגיאות C[731]. בנתונים מסימולציה עם הפרעה הדדית ודליפה, שיעור השגיאות של זיווג מתואם שכויל לרעש הזה וקיבל את ערכי הקריאה האנלוגיים היה פי 1.25 משל AlphaQubit במרחק 3, פי 1.4 במרחק 9 ופי 1.25 במרחק 11 D[657]. היתרון נשמר עד מרחק 11 בלי לגדול באופן עקבי, ומקורו ברעש שמחוץ למודל של הזיווג — הפרעה הדדית ודליפה.
הגבול החישובי הוא תנאי הפיגור: מפענח איטי מקצב הסינדרום צובר תור בלתי חסום והשעון הלוגי נעצר; בטרנסמון פירוש הדבר כ-10⁶ סבבי פענוח לשנייה לכל קיוביט לוגי. הניסוח של Google מ-2024: AlphaQubit "עדיין איטי מדי כדי לתקן שגיאות במעבד מוליך-על בזמן אמת" C[731]. קנה המידה של העלות נקבע בידי ארכיטקטורת הרשת: קשב (attention) על טלאי במרחק d עולה O(d⁴) לסבב, לעומת O(d²) לעדכון החוזר של מודל מרחב-מצבים, והמודל הזול יותר מדד סף בזמן אמת גבוה יותר, 1.04% לעומת 0.97%, משום שהפגיעה בביצועים הנגרמת מההשהיה נכללת במדד הטיב הזה S[732].
אופני הכשל סטטיסטיים: שינוי בהתפלגות (distribution shift) פוגע במודל שעבר כוונון עדין (fine-tuning) בלי שום אות שגיאה, אימון מחדש דורש נתונים מאותו מעבד, ואין סף מוכח, רק סף נמדד. מידע רך, אימון משותף עם לולאת הכיול וארכיטקטורות רשת של O(d²) היו מזיזים את הרצפה.
מצב ההנדסה העדכני
ציר הזמן של השיאים
| שנה | נתון | מי | תג+מפתח |
|---|---|---|---|
| 2024-11 | זיכרון Sycamore במרחק 5 — 2.748(15)×10⁻²/סבב לעומת 2.915(16)×10⁻² במפענח רשתות הטנזורים (~6% פחות שגיאות); שיעור השגיאות של הזיווג פי 1.25 משלו במרחק 11 בסימולציה | Google DeepMind (AlphaQubit) | D[657]fact |
| 2025-10 | מפענח מרחב-מצבים: סף בזמן אמת 1.04% לעומת 0.97% לטרנספורמר, O(d²) לעומת O(d⁴) לסבב | Yonsei University | S[732] |
| 2025-12 | הרף שאינו מבוסס רשת עצבית: מפענח אשכול בפחות מ-1 µs/סבב עד מרחק 17 על Xilinx VU19P יחיד, ~6% מתאי הלוגיקה | Riverlane | D[238]fact |
| 2026-05 | פענוח מבוסס רשת עצבית ראשון בלולאה סגורה על חומרה: פענוח ב-124 ns, מחזור תפוקה של 184 ns, לולאה של 550 ns, מרחק 3, שגיאה של 6.9(2)%/סבב לעומת 7.2(2)% בזיווג לא מקוון | International Quantum Academy | D[729] |
| 2026-07 | AlphaQubit2 מפענח את שיא Willow במרחק 7, שגיאה לוגית של 7.72(9)×10⁻⁴ למחזור, בלי ציון של פענוח בפעולה חיה; טרום-הפרסום שלו מודד פחות מ-1 µs למחזור עד מרחק 11 על TPU, על נתונים מוקלטים או מדומים | Google Quantum AI | D[2]fact |
המיטב שהודגם מתפצל לשניים: בדיוק — שיא Willow מיולי 2026, שפוענח בלי ציון של לולאה חיה D[2]; בפעולה חיה — הלולאה של Shenzhen במרחק 3 D[729]. הפענוח החי היחיד של קוד המשטח אצל Google נותר ריצת Willow מ-2024 במרחק 5, במפענח זיווג Sparse Blossom fact. הטיפוסי בקנה מידה הוא עדיין זיווג או מפענחי אשכול; גם מחוץ ל-Google מפענחים מבוססי רשתות עצביות רצים במצב לא מקוון או בלי לולאת זמן אמת מוצהרת — על Zuchongzhi 3.2, על 448-atom fault-tolerant processor ועל Sqale. תקציב השגיאה של המפענח עצמו נשלט בידי הפער בין המודל לרעש בפועל ובידי ההשהיה, לא בידי הדיוק האריתמטי — המימוש מ-Shenzhen כימת את המשקלים לשלמים של 6 ביט ולא הפסיד דבר לעומת זיווג לא מקוון D[729]. ברמת המערכת, שיא המרחק 7 מוגבל בידי שגיאות השער הדו-קיוביטי והקריאה, ולא דווח עבורו Λ D[2].
ייצור, חומרים ושרשרת האספקה
הטכנולוגיה מיוצרת רק דרך המארח שלה; נכון ל-3 בספטמבר 2026 קיימים שלושה מיקומים. בלוגיקה בטמפרטורת החדר, ה-LSTM מ-Shenzhen (32 יחידות נסתרות, מפענחי X ו-Z נפרדים, ארבעה שלבי צנרת על בלוקי DSP) נכנס ברכיב AMD Kintex-7 XC7K410T מהטווח הבינוני במרחק 3, כשהרכיבים הנוכחיים מגיעים לתקרה סביב מרחק 13 D[729]; מפענח האשכול של Riverlane תופס ~6% מטבלאות החיפוש (LUT) של Xilinx VU19P עד מרחק 17 D[238]fact — מפענח נלמד קונה דיוק בצורן. במעבדים גרפיים, NVQLink מכניס ללולאה מארח ברמת GH200 בזמן הלוך-ושוב ממוצע של 3.84 µs C[324]fact. בצורן קר, המפענח המקדים "Pinball" ב-CMOS קריוגני טוען להפחתה של 3,780× ברוחב הפס של הסינדרום בהספק של פחות מ-0.56 mW ב-4 K, אך זהו מחקר תכנון שלא יוצר S[733]fact.
AMD (Xilinx) ו-NVIDIA מספקות למעשה את כל הצורן לפענוח, ואין מקור שני בגודלי הרכיבים הנדרשים. שיעור התקינות אינו בעיה של המפענח; העבירות (portability) היא — כוונון עדין נעשה לכל מעבד בנפרד, ואיש לא פרסם כמה התקנים מכסה מודל מאומן אחד. החשיפה לפיקוח על יצוא עקיפה: המפענח נשלח כקושחה במסד בקרה, ויורש את הפיקוח החל על המאיץ ואת הסיווג של המערכת שהוא משרת.
בקרה, קריאה ועומס הקלט-פלט
העומס הוא רוחב פס והשהיה, לא קווים או לייזרים. טלאי במרחק 7 מפיק 48 ביטים מקיוביטי העזר בכל מחזור של 1.1 µs — כ-44 Mbit/s לכל קיוביט לוגי, ולכן ~4.4 Gbit/s ב-100 קיוביטים לוגיים ו-~44 Gbit/s ב-1,000, וכל ביט דורש החלטה בתוך חלון המשוב. ב-10³ קיוביטים פיזיים רכיב אחד מהטווח הבינוני מספיק. ב-10⁴ החומה היא המצרף: עשרות טלאים הדורשים זמן תגובה תת-מיקרושנייתי, וזמן ההלוך-ושוב של NVQLink, 3.84 µs, הוא שלושה מחזורים וחצי של Willow — סביר למכונות יונים ואטומים בעלות מחזור של מילישניות, גבולי לטרנסמונים אלא אם הפענוח נעשה בצמוד למקרר C[324]fact. ב-10⁶ לא מארג בטמפרטורת החדר ולא מאיץ משותף סוגרים את הלולאה, ואת הסינדרום יש לצמצם בשלב הקר S[733]. התוצאה מ-Shenzhen מוכיחה שהלולאה נסגרת בכלל: 222 ns לרכישת האות, 148 ns של לוגיקת המפענח ו-180 ns של השהיה אלקטרונית, בתוך מחזור של 1.25 µs D[729].
תפקיד במחסנית
הוא יושב על ארכיטקטורת הטרנסמונים מוליכי-העל (Google, IBM, Rigetti, IQM, Oxford Quantum Circuits, USTC/Zhejiang, Fujitsu) ועל ארכיטקטורת האטומים הניטרליים האלקליים (Harvard/MIT, QuEra, Pasqal, Infleqtion, Google), ומגיע לשתיהן. הוא דורש את קוד המשטח המסובב ואת גרסאותיו הרתומות (yoked) — כל מודל שנפרס אומן על סינדרומים של קוד המשטח, ואף אחד לא רץ על קוד בדיקת זוגיות קוונטי דליל. הוא אינו חלק מהכיול בלמידת חיזוק בתוך הלולאה: הסוכן לומד משיעור אירועי הגילוי ומשנה את משקלות גרף הזיווג, ו-AlphaQubit2 פענח את ריצת השיא המכוילת בנפרד D[2]. הוא מחליף זיווג מושלם במשקל מינימלי במחיר מעבר לא סימטרי — המעבר למפענח נלמד עולה צנרת אימון, כוונון עדין לכל התקן ואובדן הערבויות למקרה הגרוע ביותר; החזרה עולה רק דיוק.
שום דבר במבנה הרשת אינו ייחודי למוליכי-על, ולכן אותה משפחה משרתת מכונות אטומים בעלות מחזור של מילישניות במצב לא מקוון, וטרנסמונים בעלי מחזור של מיקרושניות רק עם צורן ייעודי; שונים רק נתוני האימון ותקציב ההשהיה. תרומה לשעון הנגזר (שעון נגזר = סכום סבב הסינדרום: שכבות שערים + הובלה + קריאה + איפוס עבור הארכיטקטורה): אפס, כל עוד השהיית הפענוח נשארת מתחת למחזור הסינדרום — 0.65 µs נגזר בארכיטקטורת הטרנסמונים — וכך הדבר בפעולה חיה רק במרחק 3, שבו פעולות המותנות במשוב צורכות 0.55 µs ממחזור של 1.25 µs D[729], ועד מרחק 11 רק על נתונים מוקלטים או מדומים fact. משבצות ריקות סמוכות: ASIC קריוגני של מפענח מבוסס רשת עצבית שיוצר בפועל, ומפענח נלמד לקודי bivariate bicycle על חומרה.
ראיות — כיצד נמדדו המספרים
המספרים הבולטים באים מניסויי זיכרון — מריצים N סבבי סינדרום ומשערכים את הנאמנות הלוגית כפונקציה של N — המפוענחים במצב לא מקוון או, מאז 2026, בלולאה. הפרוטוקול מחמיץ שלושה דברים. קו הבסיס הוא בחירה: על אותם נתוני Sycamore במרחק 5 עושה AlphaQubit כ-6% פחות שגיאות ממפענח רשתות הטנזורים D[657] אך כ-30% פחות מזיווג מתואם C[731], ובסימולציה עד מרחק 11 — 20–29% פחות מזיווג D[657]; לכן טווח יחיד של עדיפות על פני זיווג מערב שני קווי בסיס. ההכללה לא נבדקה: מודל שעבר כוונון עדין על מעבד אחד ונבחן עליו אינו ראיה להעברה. והתפלגויות ההשהיה מדווחות לעתים רחוקות, אף שרק הזנב שלהן גורם לפיגור.
סתירות: לגבי AlphaQubit אין סתירה — "6% פחות שגיאות משיטות רשתות הטנזורים" ו-"30% פחות שגיאות מזיווג מתואם" שבבלוג מתארים שניהם את ניסויי Sycamore הגדולים ביותר C[731], ותואמים את נתוני Nature: 5.7% פחות ממפענח רשתות הטנזורים במרחק 5 D[657]; שני האחוזים נבדלים בקו הבסיס, לא במשטר. סבב C של Riverlane הוכרז כ-$75 M (2024-08-06), אך מפת הדרכים שלה מ-2026 מציינת "$85 מיליון ב-2024" ו-"$120 מיליון+" בסך הכול C[661]fact; יש לסמוך על ההודעה מ-2024. אף קבוצה לא שחזרה את AlphaQubit2 על חומרה שאינה של Google נכון ל-3 בספטמבר 2026.
המאמר של AlphaQubit 2 עצמו הוא טרום-פרסום (arXiv:2512.07737, v2 מ-2026-03-11), וזמני הפענוח שלו, פחות מ-1 µs למחזור עד מרחק 11 על מעבדי TPU מסוג Trillium, נמדדו על נתונים מוקלטים או מדומים; לא הוא ולא המאמר ב-Nature מיולי 2026 [2] מציינים שהפענוח במרחק 7 רץ בזמן אמת fact. ספי זמן האמת ב-[732] הם תוצאת סימולציה — מודל רעש סטנדרטי של מעגלים מוליכי-על (SI1000) ועוד רעש מוזרק המייצג את השהיית המפענח. לפענוח בלמידת מכונה באטומים ניטרליים יש מקור ראשוני אחד: מידע על אובדן אטומים יחד עם פענוח בלמידת מכונה שיפר את ביצועי תיקון השגיאות פי 1.73(13) לעומת פענוח רגיל, על נתוני Harvard/MIT/QuEra מעד 448 אטומים שפוענחו בעיבוד מאוחר, והשיפור לא שוחזר מחוץ למערך נתונים זה [4]. לא פורסם: Λ לריצת AlphaQubit 2 במרחק 7, ולכן אי אפשר להפריד את תרומת המפענח מתרומת הכיול בלמידת חיזוק, וספירה מתוארכת של משפחות פטנטים למפענחים עצביים.
שחקנים וכלכלה
מי.
| ארגון | תפקיד | מדינה | מה בדיוק הם עושים | ראיות |
|---|---|---|---|---|
| Google DeepMind | מפתח | בריטניה | ארכיטקטורת הרשת והאימון של AlphaQubit ו-AlphaQubit2 | D[2], [657] |
| Google Quantum AI | מפתח | ארה״ב | פענחה את שיא Willow במרחק 7 באמצעות AlphaQubit2, בלי ציון של פענוח בפעולה חיה | D[2] |
| Riverlane | ספק | בריטניה | מוכרת את היריב הדטרמיניסטי (מפענח אשכול, Deltaflow) | D[238]C[658] |
| NVIDIA | ספק | ארה״ב | NVQLink ו-CUDA-Q QEC; זמן הלוך-ושוב של 3.84 µs עם המארח בלולאה | C[324] |
| International Quantum Academy | מחקר | סין | המפענח הראשון המבוסס על רשת עצבית בלולאה סגורה על שבב מוליך-על | D[729] |
| Qblox | ספק | הולנד | חומרת בקרה ללולאה הסגורה התת-מיקרושנייתית | C[659] |
| IBM | מפתח | ארה״ב | מפענח Relay-BP, פחות מ-1 µs/מחזור בסימולציה | S[48] |
| AMD | ספק | ארה״ב | רכיבי Kintex-7 ו-Virtex המארחים את שתי משפחות המפענחים | D[238], [729] |
כספים.
- 2024-05-01 · Riverlane · מענק EIC Transition של Horizon Europe (SkyTALE, עם Qblox) · £2.1 M · European Innovation Council · נסגר fact
- 2024-08-06 · Riverlane · סבב C · $75 M · Planet First Partners (מובילה), ETF Partners, EDBI, Cambridge Innovation Capital, Amadeus, NSSIF, Altair · החברה מציינת מאוחר יותר $85 M, ו-$120 M+ במצטבר · נסגר, שנוי במחלוקת C[661]fact
- 2025-11-17 · NVIDIA · השקת NVQLink, המחיר לא נמסר; הפריסה הראשונה: Quantinuum Helios · — · הוכרז C[324]fact
- 2025-11 · DARPA · QBI, שלב B: אחד-עשר צוותים, אף לא ספק מפענחים ייעודי אחד · — · רשומת התוכנית G[65]
- 2026-03-12 · Riverlane · מפת דרכים: 10⁶ פעולות אמינות לפני 2030, 10¹² מ-2033 · — · מפת דרכים CR[658]fact
- 2026-03-17 · Qblox ו-Riverlane · הדגמה בלולאה סגורה, 250 קיוביטים פיזיים / 1 לוגי, 10,000 פעולות · — · הוכרז C[659]fact
שוק ושרשרת אספקה. אין שוק מפענחים במובן הרגיל: המפענח של Google פנימי, לשימושה בלבד, והספק המסחרי העצמאי היחיד בעל משקל, Riverlane, מוכר מפענח דטרמיניסטי ולא מודל מאומן. הציוד המאפשר הוא לוגיקה ניתנת לתכנות של AMD, מאיצים של NVIDIA ומסדי בקרה של Qblox, Zurich Instruments ו-Quantum Machines; סיכון הריכוזיות נמצא אצל שני ספקים אמריקניים. לכלכלת היחידה אין נתונים שאפשר לצטט; נתוני המשאבים נותנים מדד עקיף: סדר גודל אחד עד שניים יותר צורן לכל קיוביט לוגי מאשר במפענח אשכול. G3 ו-G4 משלמים על הטכנולוגיה הזאת, ו-G7 משלם עליה כרכיב משובץ; G1, G2 ו-G5 אינם משלמים, שכן מכונות אנלוגיות ומכונות עם הפחתת שגיאות אינן פולטות סינדרומים.
קניין רוחני ותקנים. Riverlane מחזיקה ב-GB 2641501 A, "Quantum decoder" (Ziad, Zalawadiya, Barber, Skoric; הוגש 2024-05-31, פורסם 2025-12-10), על רכיבי עיבוד מקובצים המריצים אשכול בחומרה — בסמוך למודלים נלמדים, ולא עליהם G[662]fact. Google LLC מחזיקה ב-US 12,518,194 (הוענק 2026-01-06) על קודי משטח עם אופרטורי כיול (gauge) ארוזים בצפיפות, המעצבים את הסינדרום שהמפענח קורא G[656]. לא נמצאה ספירה מתוארכת במאגר פטנטים של משפחות פטנטים על מפענחים מבוססי רשתות עצביות. תקנים אין; הממשקים בפועל הם NVQLink ו-CUDA-Q QEC, מול Stim, PyMatching ו-Tesseract בקוד פתוח.
מפות דרכים ועמידה בהבטחות. Google DeepMind: "איטי מדי לזמן אמת" (2024-11) · פענוח בזמן אמת · פחות מ-1 µs למחזור עד מרחק 11 על נתונים מוקלטים או מדומים (קדם-פרסום, 2025-12-08), ובלי ציון של פענוח בפעולה חיה לשיא במרחק 7 מ-2026-07-08 — טרם סופק על חומרה factD[2]. Riverlane: פענוח חומרה תת-מיקרושנייתי עד מרחק 17 (2024–25) · סופק 2025-12 D[238]; 10⁶ פעולות לפני 2030 (2026-03) · עדיין לא ניתן לבדיקה R[658]. NVIDIA: קישור קוונטי-קלאסי בהשהיה של מיקרושניות בודדות (2025-11) · הודגם עם IQM עד 2026-03 P[239]. IBM: Relay-BP בפחות מ-1 µs/מחזור (2025-10) · בסימולציה בלבד, מודול היעד נדחה בשנה S[48]. Google מספקת ומפרסמת; Riverlane מספקת בהנדסה אך אינה מדייקת בהיסטוריית המימון שלה; NVIDIA מספקת תשתית; הבטחות המפענח של IBM מקדימות את החומרה שלה.
פרשנות אסטרטגית. אם פענוח נלמד יהפוך להכרחי ולא רק לטוב יותר, הערך יעבור מספק המעבד אל מי שמחזיק במודל המאומן ובצורן שמתחתיו — ורק Google מחזיקה בשבב, בלולאת הבקרה ובמודל יחד. IBM, Rigetti, IQM ו-Oxford Quantum Circuits יקנו פענוח — זו התזה של Riverlane. השניים עשויים להתפצל לפי משטר: פענוח נלמד היכן שהדיוק מגביל, אשכול היכן שהתפוקה מגבילה. איום התחליף הוא הפיזיקה — המרה למחיקה ושיעורי שגיאה פיזיים נמוכים יותר מכווצים את השארית שאינה דמוית-גרף, שבעבור מידולה משלמים על הרשת. כוח המיקוח נמצא בידי AMD ו-NVIDIA, המוכרות לכל הענפים.
תחזית ושאלות פתוחות
לאשר אם עד 2027-09 מפענח נלמד ירוץ בפעולה חיה בזמן אמת במרחק ≥ 9 עם זנבות השהיה מפורסמים, יפענח קוד קוונטי דליל על חומרה, או יימסר לייצור כ-ASIC. להוריד בדרגה אם עד 2028-09 אף מפענח נלמד לא ירוץ בפעולה חיה מעבר למרחק 7, או אם מפענח ממשפחת הזיווג יגיע לטווח של 5% מהדיוק של מפענח נלמד במרחק ≥ 11 — דבר שיהפוך את פרמיית הצורן לבלתי ניתנת להצדקה. התרחיש הטוב ביותר עד 2029: פענוח נלמד הוא ברירת המחדל במכונות מוליכי-על במרחק 15–25 על צורן קר, וקונה צעד מרחק של חיסכון בקיוביטים פיזיים. התרחיש הגרוע ביותר: המרה למחיקה ושיעורי שגיאה פיזיים טובים יותר הופכים מפענחים מבוססי-גרף למספיקים, והחומה סביב מרחק 13 לעולם אינה נחצית.
שאלות פתוחות. (1) האם יתרון הדיוק גדל, מתייצב או מתהפך עם המרחק כשההשהיה נזקפת ביושר? (2) באיזו מהירות מודל שעבר כוונון עדין מידרדר בין כיול לכיול, והאם אפשר לשלב את האימון בתוך סוכן הכיול שבלולאה? (3) האם יש ארכיטקטורת רשת השומרת על עלות O(d²) עם יכולת מלאה למדל רעש מתואם מחוץ לסימולציה? (4) האם אפשר להעניק הסמכה למפענח נלמד כשהמקרה הגרוע ביותר שלו אינו חסום? (5) מי משלם כשספקי המעבד והמפענח שונים?
לעקוב אחר: תוצאה של AlphaQubit2 על חומרה שאינה של Google; המפענח הראשון המבוסס על רשת עצבית על קוד bivariate bicycle; מסירה לייצור של מפענח קריוגני; והשהיית NVQLink טובה דיה לפענוח במאיץ משותף בטרנסמונים.
מקורות
- [1] Google Quantum AI and Collaborators, “Quantum error correction below the surface code threshold,” Nature, vol. 638, no. 8052, pp. 920–926, Dec. 2024, doi: 10.1038/s41586-024-08449-y. [D]
- [2] V. Sivak et al., “Reinforcement learning control of quantum error correction,” Nature, vol. 655, no. 8124, pp. 879–884, Jul. 2026, doi: 10.1038/s41586-026-10759-2. [D]
- [4] D. Bluvstein et al., “A fault-tolerant neutral-atom architecture for universal quantum computation,” Nature, vol. 649, no. 8095, pp. 39–46, Nov. 2025, doi: 10.1038/s41586-025-09848-5. arXiv:2506.20661. [D]
- [48] T. Maurer et al., “Real-time decoding of the gross code memory with FPGAs,” arXiv:2510.21600, Oct. 2025. [S]
- [65] DARPA, “Stage B selection,” Nov. 6, 2025. [Online]. Available: https://www.darpa.mil/
research/ [G]programs/ quantum-benchmarking-initiative/ stage-b-selection - [238] A. B. Ziad et al., “Local clustering decoder as a fast and adaptive hardware decoder for the surface code,” Nat. Commun., vol. 16, no. 1, Art. no. 11048, Dec. 2025, doi: 10.1038/s41467-025-66773-x. [D]
- [239] M. Abdel-Kareem, “IQM and Zurich Instruments Develop Real-Time QEC via NVIDIA NVQLink,” Quantum Computing Report, Mar. 17, 2026. [Online]. Available: https://quantumcomputingreport.com/
iqm-and-zurich-instruments-develop-real-time-qec-via-nvidia-nvqlink/ [P] - [324] S. Caldwell et al., “NVIDIA NVQLink Architecture Integrates Accelerated Computing with Quantum Processors,” NVIDIA Technical Blog, Nov. 17, 2025. [Online]. Available: https://developer.nvidia.com/
blog/ [C]nvidia-nvqlink-architecture-integrates-accelerated-computing-with-quantum-processors/ - [656] Google LLC, “Surface codes with densely packed gauge operators,” U.S. Patent 12,518,194 B2, Jan. 6, 2026. [Online]. Available: https://patents.google.com/
patent/ Also https://patents.justia.com/US12518194B2/ en search?q=%22surface+code%22+quantum+error+correction&company=google . [G] - [657] J. Bausch et al., “Learning high-accuracy error decoding for quantum processors,” Nature, vol. 635, no. 8040, pp. 834–840, Nov. 2024, doi: 10.1038/s41586-024-08148-8. [D]
- [658] Riverlane, “Riverlane publishes QEC Technology Roadmap that can accelerate quantum computing's path to utility scale by 3–5 years,” Mar. 12, 2026. [Online]. Available: https://www.riverlane.com/
press-release/ [R]riverlane-publishes-qec-technology-roadmap - [659] Qblox; Riverlane, “Qblox and Riverlane Demonstrate Integration Enabling Real-Time Quantum Error Correction,” PR Newswire, Mar. 17, 2026. [Online]. Available: https://www.prnewswire.com/
news-releases/ [C]qblox-and-riverlane-demonstrate-integration-enabling-real-time-quantum-error-correction-302716254.html - [661] Riverlane, “Riverlane raises $75 million to meet surging global demand for quantum error correction technology,” Aug. 6, 2024. [Online]. Available: https://www.riverlane.com/
press-release/ [C]riverlane-raises-75-million-to-meet-surging-global-demand-for-quantum-error-correction-technology - [662] A. B. Ziad, A. Zalawadiya, B. Barber, and L. Skoric, “Quantum decoder,” Google Patents, Dec. 10, 2025. [Online]. Available: https://patents.google.com/
patent/ [G]GB2641501A/ en - [729] X. Yang et al., “Real-time Surface-Code Error Correction Using an FPGA-based Neural-Network Decoder,” arXiv:2605.04892, May 2026. Also https://arxiv.org/
html/ . [D]2605.04892 - [731] Google DeepMind and Google Quantum AI, “AlphaQubit tackles one of quantum computing's biggest challenges,” Google The Keyword, Nov. 20, 2024. [Online]. Available: https://blog.google/
innovation-and-ai/ [C]models-and-research/ google-deepmind/ alphaqubit-quantum-error-correction/ - [732] C. Lee, T. Hur, and D. K. Park, “Scalable Neural Decoders for Practical Real-Time Quantum Error Correction,” arXiv:2510.22724, Oct. 2025. [S]
- [733] A. Knapen et al., “Pinball: A Cryogenic Predecoder for Surface Code Decoding Under Circuit-Level Noise,” arXiv:2512.09807, Dec. 2025. [S]