Нейросетевые декодеры (AlphaQubit 2, CNN, трансформеры) dec_nn
Обучаемые декодеры синдрома — рекуррентные трансформеры, CNN, LSTM, модели пространства состояний, — которые обходят паросочетание (matching) за счёт усвоения непаулевского шума устройства прямо из данных.
Нейросетевые декодеры (AlphaQubit 2, CNN, трансформеры)
Обучаемые декодеры делают на ~6% меньше ошибок, чем тензорно-сетевой декодер, и на ~30% меньше, чем коррелированное паросочетание, на данных Sycamore, а в моделировании до d=11 — на 20–29% меньше, чем паросочетание; нейросетевой декодер на ПЛИС — 124 ns при d=3; пропускная способность быстрее 1 µs на цикл показана до d=11, на записанных или смоделированных данных, не вживую.
Обзор →Ключевые источники
Пространство проектирования — атрибуты
- (a) сродство носителя
- промежуточный / не зависящий от носителя
- (b) время · запутывание
- —
- (c) считывание
- —
- (d) подвижность
- —
- (e) управление
- —
- (f) структура ошибки
- стохастическая паулиевская
- (g) производство
- —
Пространство оценки — датированные атрибуты
Стандартные рекорды
Участники и цели — аннотации
Рёбра
Используют 7 машин (4 основная · 3 альтернатива)
- сверхпроводниковые схемы 3
- Zuchongzhi 3.2 USTC / Hefei National Laboratory ▣ Fig. 2d, 3c (decoded fidelities); main text: neural-network decoder ✅
- Sycamore-class 72-qubit processor Google Quantum AI статья статья ▤ 🔎 (альтернатива)
- Willow Google Quantum AI статья статья страница продукта ▤ ✅ (альтернатива)
- нейтральные атомы 4
- Infleqtion Illinois neutral-atom quantum computer (IQMP, Chicago) Infleqtion пресса ◌ 🔎
- Sqale Infleqtion пресса ▨ ✅
- Quantum X Labs neutral-atom platform (50+ qubits, claimed) Quantum X Labs Inc. (Nasdaq: QXL) пресса ссылка ▨ 🔎
- 448-atom fault-tolerant processor Harvard / MIT / QuEra статья пресса ▣ Fig. 2 (logical error per round: machine learning with/without loss information) ✅ (альтернатива)
Иллюстрации
У каждой иллюстрации — рассказ о том, что на ней, и строка авторства.
Нейросетевые декодеры (AlphaQubit 2, CNN, трансформеры)
Обучаемые декодеры синдрома — рекуррентные трансформеры, CNN, LSTM, модели пространства состояний, — которые обходят паросочетание (matching) за счёт усвоения непаулевского шума устройства прямо из данных.
Вердикт. Преимущество по точности реально, но скорость реального времени показана лишь на записанных или смоделированных данных, до расстояния 11, а вживую — только на расстоянии 3; открытый вопрос — переживёт ли преимущество живую пропускную способность и дрейф за расстоянием 11.
Λ — коэффициент подавления ошибок на шаг кодового расстояния; QBI — DARPA Quantum Benchmarking Initiative (Stage A — концепция → B — план НИОКР → C — государственная верификация и валидация); G1–G7 — классы целей отчёта (см. «Участники и экономика»).
Сущность и происхождение
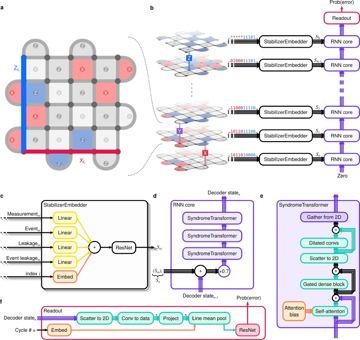
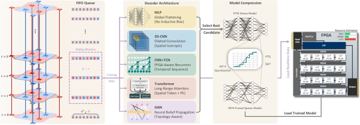
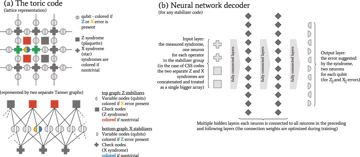
Нейросетевой декодер заменяет комбинаторный шаг вывода в коррекции ошибок обученным аппроксиматором функции: на входе история синдрома, на выходе логическая коррекция. Декодирование — это байесовский вывод на гиперграфе ошибок детекторов, и совершенное паросочетание минимального веса (MWPM) точно лишь тогда, когда этот гиперграф графоподобен: каждая ошибка переключает не более двух детекторов, а вероятности независимы, известны и статичны. Реальные устройства нарушают все три условия: утечка (leakage) выводит кубит из вычислительного подпространства на много раундов, коррелированные всплески связывают удалённые детекторы, считывание до порогования аналогово, а шум дрейфует. Обучаемый декодер вместо этого подгоняет совместное распределение по размеченным данным, потребляя мягкие значения считывания и флаги утечки, которые паросочетание представить не способно. Линия происхождения тянется от свёрточных декодеров (2017) к рекуррентно-трансформерному AlphaQubit, опубликованному Google DeepMind совместно с Google Quantum AI 2024-11-20 D[657]факт, и далее к AlphaQubit2, названному в июльской статье 2026 года по Willow «масштабируемым нейросетевым декодером реального времени для топологических квантовых кодов» D[2].
Атрибуты: сродство к носителю 0.5 и собственного носителя нет; характерного времени и запутывающей операции нет — наследуется период синдрома хоста (1.1 µs на Willow D[1]факт); считывания нет, хотя декодер потребляет те мягкие значения, которые паросочетание отбрасывает; подвижности нет за пределами графа ошибок детекторов, на котором он обучен; модальности управления нет — переменной является размещение: сегодня логика при комнатной температуре, предлагается холодный кремний; структура ошибок паулевская, при том что ценность узла — именно в непаулевском остатке; собственного производства нет.
Физика и пределы
Нижняя граница здесь теоретико-информационная и вычислительная, а не физическая: потолком служит декодирование по максимуму правдоподобия, и паросочетание лежит измеримо ниже него. На данных Sycamore AlphaQubit достиг логической ошибки 2.748(15)×10⁻² на раунд при расстоянии 5 против 2.915(16)×10⁻² у тензорно-сетевого декодера — приближённого декодера максимального правдоподобия — и 2.901(23)×10⁻² против 3.028(23)×10⁻² при расстоянии 3, то есть примерно на 6% и 4% меньше ошибок D[657]; относительно коррелированного паросочетания при расстоянии 5 ошибок было меньше примерно на 30% C[731]. На моделируемых данных с перекрёстными помехами и утечкой коррелированное паросочетание, настроенное на этот шум и получающее аналоговые значения считывания, давало в 1.25 раза больше ошибок, чем AlphaQubit, при расстоянии 3, в 1.4 раза — при 9 и в 1.25 раза — при 11 D[657]. Преимущество сохраняется вплоть до расстояния 11, но не растёт монотонно, и происходит оно от шума, выходящего за модель паросочетания, — перекрёстных помех и утечки.
Вычислительный предел — это условие отставания (backlog): декодер, работающий медленнее темпа поступления синдрома, накапливает неограниченную очередь, и логический такт останавливается; для трансмона это означает примерно 10⁶ раундов декодирования в секунду на логический кубит. Формулировка Google образца 2024 года: AlphaQubit «всё ещё слишком медленный, чтобы исправлять ошибки в сверхпроводниковом процессоре в реальном времени» C[731]. Масштабирование стоимости определяется архитектурой: внимание по патчу расстояния d стоит O(d⁴) на раунд против O(d²) у рекуррентности в пространстве состояний, и у более дешёвой модели измеренный порог реального времени оказался выше — 1.04% против 0.97%, — поскольку деградация, вызванная задержкой, входит в этот показатель качества S[732].
Режимы отказа статистические: сдвиг распределения ухудшает дообученную модель, не подавая при этом никакого сигнала об ошибке, переобучение требует данных с того же самого процессора, а доказанного порога не существует — есть только измеренный. Сдвинуть эту границу способны мягкая информация, совместное обучение с контуром калибровки и архитектуры со стоимостью O(d²).
Достигнутый инженерный уровень
Хронология рекордов
| Год | Показатель | Кто | Тег+ключ |
|---|---|---|---|
| 2024-11 | Память Sycamore на расстоянии 5: 2.748(15)×10⁻²/раунд против 2.915(16)×10⁻² у тензорно-сетевого декодера (~6% меньше ошибок); у паросочетания на моделируемом расстоянии 11 ошибок в 1.25 раза больше | Google DeepMind (AlphaQubit) | D[657]факт |
| 2025-10 | Декодер в пространстве состояний: порог реального времени 1.04% против 0.97% у трансформера, O(d²) против O(d⁴) на раунд | Yonsei University | S[732] |
| 2025-12 | Ненейросетевая планка: кластеризующий декодер, менее 1 µs/раунд вплоть до расстояния 17 на одной Xilinx VU19P, ~6% логических ячеек | Riverlane | D[238]факт |
| 2026-05 | Первое нейросетевое декодирование в замкнутом контуре на аппаратуре: 124 ns декодирование, 184 ns период пропускной способности, 550 ns контур, расстояние 3, 6.9(2)%/раунд против 7.2(2)% у офлайнового паросочетания | International Quantum Academy | D[729] |
| 2026-07 | AlphaQubit2 декодирует рекорд Willow на расстоянии 7 — логическая ошибка 7.72(9)×10⁻⁴ за цикл — без указания на живое декодирование; его собственный препринт даёт менее 1 µs на цикл до расстояния 11 на TPU, на записанных или смоделированных данных | Google Quantum AI | D[2]факт |
Лучшее продемонстрированное распадается надвое: по точности — июльский рекорд 2026 года на Willow, декодированный без указания на живой контур D[2]; по живой работе — шэньчжэньский контур на расстоянии 3 D[729]. Единственное живое декодирование поверхностного кода у Google по-прежнему — прогон 2024 года на Willow на расстоянии 5 с декодером паросочетания Sparse Blossom факт. Типичное же в масштабе — по-прежнему паросочетание или кластеризация; и за пределами Google нейросетевые декодеры работают офлайн или без заявленного контура реального времени — на Zuchongzhi 3.2, 448-atom fault-tolerant processor и Sqale. В собственном бюджете декодера доминируют рассогласование модели и задержка, а не разрядность арифметики: шэньчжэньская реализация квантовала веса до 6-битных целых и ничего не потеряла относительно офлайнового паросочетания D[729]. На системном уровне рекорд на расстоянии 7 ограничен ошибками двухкубитных вентилей и считывания, и Λ для него не приводится D[2].
Производство, материалы и цепочка поставок
Узел изготавливается только через свой хост; по состоянию на 3 сентября 2026 г. существует три варианта размещения. В логике комнатной температуры шэньчжэньская LSTM (32 скрытых элемента, раздельные X- и Z-декодеры, четыре конвейерные ступени на DSP-блоках) укладывается в средний по классу AMD Kintex-7 XC7K410T при расстоянии 3, а потолок нынешних кристаллов лежит около расстояния 13 D[729]; кластеризующий декодер Riverlane занимает ~6% таблиц соответствия Xilinx VU19P вплоть до расстояния 17 D[238]факт — обучаемый декодер покупает точность кремнием. На графических процессорах NVQLink вводит хост класса GH200 в контур со средним временем оборота 3.84 µs C[324]факт. В холодном кремнии крио-КМОП-предекодер «Pinball» заявляет сокращение полосы синдрома в 3 780× при мощности менее 0.56 mW на 4 K, но это неизготовленное проектное исследование S[733]факт.
AMD (Xilinx) и NVIDIA поставляют практически весь кремний для декодирования, и второго источника кристаллов требуемого размера нет. Выход годных для декодера не проблема; проблема — переносимость: дообучение выполняется под конкретный процессор, и никто не опубликовал, сколько устройств покрывает одна обученная модель. Экспортная уязвимость косвенная: декодер поставляется как прошивка в стойке управления и наследует ограничения на ускоритель и классификацию той системы, которую обслуживает.
Управление, считывание и нагрузка на ввод-вывод
Нагрузка здесь — полоса и задержка, а не линии или лазеры. Патч расстояния 7 выдаёт 48 бит анцилл за цикл 1.1 µs — около 44 Mbit/s на логический кубит, то есть ~4.4 Gbit/s при 100 логических кубитах и ~44 Gbit/s при 1 000, причём по каждому биту требуется решение внутри окна обратной связи. При 10³ физических кубитах достаточно одного кристалла среднего класса. При 10⁴ стена становится совокупной: десятки патчей требуют субмикросекундного отклика, а оборот NVQLink в 3.84 µs — это три с половиной цикла Willow: приемлемо для ионных и атомных машин с миллисекундным циклом, на грани для трансмонов, если декодирование не размещено локально в криостате C[324]факт. При 10⁶ не сходятся ни программируемая матрица комнатной температуры, ни разделяемый ускоритель, и синдром приходится сокращать уже на холодной ступени S[733]. Шэньчжэньский результат доказывает, что контур в принципе замыкается: 222 ns на сбор данных, 148 ns на логику декодера и 180 ns электронной задержки внутри цикла 1.25 µs D[729].
Роль в стеке
Узел лежит на архитектуре сверхпроводниковых трансмонов (Google, IBM, Rigetti, IQM, Oxford Quantum Circuits, USTC/Zhejiang, Fujitsu) и на архитектуре нейтральных атомов щелочных металлов (Harvard/MIT, QuEra, Pasqal, Infleqtion, Google), доставая до обеих. Он требует повёрнутого поверхностного кода и его сопряжённых (yoked) вариантов: каждая развёрнутая модель обучена на синдромах поверхностного кода, и ни одна не работала на разреженном квантовом коде с проверкой чётности. В контур калибровки с обучением с подкреплением он не входит: агент учится по частоте событий детекции и перевзвешивает граф паросочетаний, а AlphaQubit2 декодировал откалиброванный рекордный прогон отдельно D[2]. Он замещает совершенное паросочетание минимального веса при асимметричной цене перехода: переход к обучаемому декодеру стоит конвейера обучения, дообучения под каждое устройство и гарантий наихудшего случая; обратный переход стоит только точности.
В архитектуре нет ничего специфически сверхпроводникового, поэтому одно и то же семейство обслуживает атомные машины с миллисекундным циклом офлайн, а трансмоны с микросекундным циклом — только при наличии выделенного кремния; различаются лишь обучающие данные и бюджет задержки. Вклад в производный такт (производный такт = сумма раунда синдрома: слои вентилей + транспорт + считывание + сброс для данной архитектуры): нулевой, пока задержка декодирования остаётся ниже периода синдрома — 0.65 µs производного такта на трансмонной архитектуре, — что вживую выполняется лишь на расстоянии 3, где операции, обусловленные обратной связью, съедают 0.55 µs из цикла 1.25 µs D[729], а до расстояния 11 — только на записанных или смоделированных данных факт. Соседние пустые слоты: изготовленная криогенная ASIC нейросетевого декодера и обучаемый декодер для кодов bivariate-bicycle на аппаратуре.
Свидетельства — как измерены числа
Ключевые цифры получены из экспериментов с памятью — прогнать N раундов синдрома, подогнать логическую точность (fidelity) как функцию N — при декодировании офлайн либо, начиная с 2026 года, прямо в контуре. Протокол упускает три вещи. Базовая линия — вопрос выбора: на одних и тех же данных Sycamore при расстоянии 5 AlphaQubit делает примерно на 6% меньше ошибок, чем тензорно-сетевой декодер D[657], но примерно на 30% меньше, чем коррелированное паросочетание C[731], а в моделировании до расстояния 11 — на 20–29% меньше, чем паросочетание D[657]; поэтому единая полоса превосходства над паросочетанием смешивает две базовые линии. Обобщающая способность не проверена: модель, дообученная на одном процессоре и на нём же оценённая, свидетельством переноса не является. И распределения задержки публикуются редко, хотя отставание вызывает именно хвост этого распределения.
Противоречия: по AlphaQubit противоречия нет — «на 6% меньше ошибок, чем у тензорно-сетевых методов» и «на 30% меньше ошибок, чем у коррелированного паросочетания» в блоге относятся к одним и тем же крупнейшим экспериментам на Sycamore C[731] и согласуются с цифрами Nature — 5.7% относительно тензорно-сетевого декодера на расстоянии 5 D[657]; эти проценты различаются базовой линией, а не режимом. Раунд серии C у Riverlane объявлен как $75 M (2024-08-06), но дорожная карта 2026 года указывает «$85 million in 2024» и суммарно «$120 million+» C[661]факт; доверять следует релизу 2024 года. По состоянию на 3 сентября 2026 г. ни одна группа не воспроизвела AlphaQubit2 на аппаратуре вне Google.
Собственная статья AlphaQubit 2 — препринт (arXiv:2512.07737, v2 от 2026-03-11), и её времена менее 1 µs на цикл до дистанции 11 на TPU Trillium получены на записанных или смоделированных данных; ни она, ни июльская статья 2026 г. в Nature [2] не утверждают, что декодирование при дистанции 7 шло в реальном времени факт. Пороги реального времени в [732] получены моделированием — стандартная модель шума сверхпроводниковой схемы (SI1000) плюс внесённый шум, отражающий задержку декодера. Для нейтральных атомов у машинно-обученного декодирования один первичный источник: информация о потере атомов вместе с машинно-обученным декодированием улучшила качество коррекции ошибок в 1.73(13)× по сравнению с обычным декодированием на данных Harvard/MIT/QuEra до 448 атомов, декодированных постфактум, и за пределами этого набора данных выигрыш не воспроизведён [4]. Не опубликовано: Λ для прогона AlphaQubit 2 при дистанции 7, поэтому вклад декодера нельзя отделить от вклада калибровки обучением с подкреплением, а также датированное число патентных семейств по нейросетевым декодерам.
Участники и экономика
Кто.
| Организация | Роль | Страна | Что именно делает с технологией | Свидетельство |
|---|---|---|---|---|
| Google DeepMind | разработчик | Великобритания | Архитектура и обучение AlphaQubit и AlphaQubit2 | D[2], [657] |
| Google Quantum AI | разработчик | США | Декодировал с AlphaQubit2 рекорд Willow на расстоянии 7, без указания на живое декодирование | D[2] |
| Riverlane | поставщик | Великобритания | Продаёт детерминированного конкурента (кластеризующий декодер, Deltaflow) | D[238]C[658] |
| NVIDIA | поставщик | США | NVQLink и CUDA-Q QEC; оборот 3.84 µs с хостом в контуре | C[324] |
| International Quantum Academy | исследования | Китай | Первый нейросетевой декодер в замкнутом контуре на сверхпроводниковом чипе | D[729] |
| Qblox | поставщик | Нидерланды | Аппаратура управления для субмикросекундного замкнутого контура | C[659] |
| IBM | разработчик | США | Декодер Relay-BP, менее 1 µs/цикл в моделировании | S[48] |
| AMD | поставщик | США | Кристаллы Kintex-7 и Virtex, несущие оба семейства декодеров | D[238], [729] |
Деньги.
- 2024-05-01 · Riverlane · грант Horizon Europe EIC Transition (SkyTALE, совместно с Qblox) · £2.1 M · European Innovation Council · закрыт факт
- 2024-08-06 · Riverlane · раунд серии C · $75 M · Planet First Partners (лид), ETF Partners, EDBI, Cambridge Innovation Capital, Amadeus, NSSIF, Altair · позднее компания указывает $85 M и суммарно $120 M+ · закрыт, оспаривается C[661]факт
- 2025-11-17 · NVIDIA · запуск NVQLink, цена не раскрыта; первое развёртывание — Quantinuum Helios · — · объявлено C[324]факт
- 2025-11 · DARPA · QBI Stage B: одиннадцать команд, ни одного чистого поставщика декодеров · — · программная запись G[65]
- 2026-03-12 · Riverlane · дорожная карта: 10⁶ надёжных операций до 2030 года, 10¹² с 2033 года · — · дорожная карта CR[658]факт
- 2026-03-17 · Qblox и Riverlane · демонстрация замкнутого контура, 250 физических / 1 логический кубит, 10 000 операций · — · объявлено C[659]факт
Рынок и цепочка поставок. Рынка декодеров в обычном смысле не существует: декодер Google целиком внутренний, а единственный значимый независимый поставщик, Riverlane, продаёт детерминированный декодер, а не обученную модель. Обеспечивающее оборудование — программируемая логика AMD, ускорители NVIDIA и стойки управления Qblox, Zurich Instruments и Quantum Machines; риск концентрации приходится на двух американских поставщиков. Удельную экономику указать нечем; данные по ресурсам дают косвенную оценку: на один-два порядка больше кремния на логический кубит, чем у кластеризации. За этот узел платят G3 и G4, а G7 платит за него во встроенном виде; G1, G2 и G5 не платят, поскольку аналоговые машины и машины с подавлением ошибок синдромов не выдают.
Интеллектуальная собственность и стандарты. Riverlane владеет GB 2641501 A «Quantum decoder» (Ziad, Zalawadiya, Barber, Skoric; заявка 2024-05-31, публикация 2025-12-10) на сгруппированные обрабатывающие элементы, выполняющие кластеризацию аппаратно, — это смежная к обучаемым моделям область, а не они сами G[662]факт. Google LLC владеет US 12,518,194 (выдан 2026-01-06) на поверхностные коды с плотно упакованными калибровочными операторами, что задаёт форму синдрома, который читает декодер G[656]. Датированного подсчёта семейств патентов по нейросетевым декодерам найти не удалось. Стандарты отсутствуют; де-факто интерфейсами служат NVQLink и CUDA-Q QEC — на фоне открытых Stim, PyMatching и Tesseract.
Дорожные карты и послужной список. Google DeepMind: «слишком медленно для реального времени» (2024-11) · декодирование в реальном времени · менее 1 µs на цикл до расстояния 11 на записанных или смоделированных данных (препринт, 2025-12-08), а для рекорда на расстоянии 7 от 2026-07-08 живое декодирование не заявлено — на аппаратуре пока не выполнено фактD[2]. Riverlane: субмикросекундное аппаратное декодирование вплоть до расстояния 17 (2024–25) · выполнено 2025-12 D[238]; 10⁶ операций до 2030 года (2026-03) · пока не поддаётся проверке R[658]. NVIDIA: квантово-классический канал с задержкой в единицы микросекунд (2025-11) · продемонстрировано совместно с IQM к 2026-03 P[239]. IBM: Relay-BP менее 1 µs/цикл (2025-10) · только моделирование, целевой модуль сдвинулся на год S[48]. Google обещанное выполняет и публикует; Riverlane выполняет инженерные обещания, но вольно обращается с историей собственного финансирования; NVIDIA поставляет обвязку; обещания IBM по декодерам опережают её аппаратуру.
Стратегическое прочтение. Если обучаемое декодирование станет необходимым, а не просто более выгодным, стоимость сместится от поставщика процессора к тому, кто владеет обученной моделью и кремнием под ней, — а чипом, контуром управления и моделью одновременно владеет только Google. IBM, Rigetti, IQM и Oxford Quantum Circuits будут декодирование покупать — в этом и состоит тезис Riverlane. Два подхода могут разделиться по режимам: обучаемый там, где ограничивает точность, кластеризация там, где ограничивает пропускная способность. Угроза замещения исходит от физики: преобразование ошибок в стирания (erasure) и снижение физических частот ошибок сокращают неграфоподобный остаток, ради моделирования которого сеть и содержат. Переговорная сила у AMD и NVIDIA, продающих во все ветви сразу.
Перспективы и открытые вопросы
Подтвердить, если к 2027-09 обучаемый декодер заработает вживую в реальном времени на расстоянии ≥ 9 с опубликованными хвостами задержки, декодирует разреженный квантовый код на аппаратуре или пройдёт tape-out в виде ASIC. Понизить, если к 2028-09 ни один не заработает вживую дальше расстояния 7 либо декодер класса паросочетания подойдёт к точности обучаемого ближе чем на 5% при расстоянии ≥ 11 — тогда премия за кремний станет неоправданной. Лучший сценарий к 2029 году: обучаемое декодирование становится вариантом по умолчанию на сверхпроводниковых машинах при расстояниях 15–25 на холодном кремнии, окупая себя экономией физических кубитов размером в один шаг расстояния. Худший сценарий: преобразование ошибок в стирания и улучшение физических частот ошибок делают графоподобные декодеры достаточными, и стена около расстояния 13 так и не преодолевается.
Открытые вопросы. (1) Растёт ли преимущество по точности с расстоянием, выходит ли на плато или обращается, если задержка учтена честно? (2) Насколько быстро деградирует дообученная модель между калибровками и можно ли свернуть обучение в агент калибровки внутри контура? (3) Существует ли архитектура, сохраняющая стоимость O(d²) при полной способности учитывать коррелированный шум вне моделирования? (4) Можно ли сертифицировать обучаемый декодер, если его наихудший случай не ограничен? (5) Кто платит, когда поставщик процессора и поставщик декодера — разные компании?
Следить за: результатом AlphaQubit2 на аппаратуре вне Google; первым нейросетевым декодером на коде bivariate-bicycle; tape-out криогенного декодера; и задержкой NVQLink, достаточной для декодирования на разделяемом ускорителе для трансмонов.
Литература
- [1] Google Quantum AI and Collaborators, “Quantum error correction below the surface code threshold,” Nature, vol. 638, no. 8052, pp. 920–926, Dec. 2024, doi: 10.1038/s41586-024-08449-y. [D]
- [2] V. Sivak et al., “Reinforcement learning control of quantum error correction,” Nature, vol. 655, no. 8124, pp. 879–884, Jul. 2026, doi: 10.1038/s41586-026-10759-2. [D]
- [4] D. Bluvstein et al., “A fault-tolerant neutral-atom architecture for universal quantum computation,” Nature, vol. 649, no. 8095, pp. 39–46, Nov. 2025, doi: 10.1038/s41586-025-09848-5. arXiv:2506.20661. [D]
- [48] T. Maurer et al., “Real-time decoding of the gross code memory with FPGAs,” arXiv:2510.21600, Oct. 2025. [S]
- [65] DARPA, “Stage B selection,” Nov. 6, 2025. [Online]. Available: https://www.darpa.mil/
research/ [G]programs/ quantum-benchmarking-initiative/ stage-b-selection - [238] A. B. Ziad et al., “Local clustering decoder as a fast and adaptive hardware decoder for the surface code,” Nat. Commun., vol. 16, no. 1, Art. no. 11048, Dec. 2025, doi: 10.1038/s41467-025-66773-x. [D]
- [239] M. Abdel-Kareem, “IQM and Zurich Instruments Develop Real-Time QEC via NVIDIA NVQLink,” Quantum Computing Report, Mar. 17, 2026. [Online]. Available: https://quantumcomputingreport.com/
iqm-and-zurich-instruments-develop-real-time-qec-via-nvidia-nvqlink/ [P] - [324] S. Caldwell et al., “NVIDIA NVQLink Architecture Integrates Accelerated Computing with Quantum Processors,” NVIDIA Technical Blog, Nov. 17, 2025. [Online]. Available: https://developer.nvidia.com/
blog/ [C]nvidia-nvqlink-architecture-integrates-accelerated-computing-with-quantum-processors/ - [656] Google LLC, “Surface codes with densely packed gauge operators,” U.S. Patent 12,518,194 B2, Jan. 6, 2026. [Online]. Available: https://patents.google.com/
patent/ Also https://patents.justia.com/US12518194B2/ en search?q=%22surface+code%22+quantum+error+correction&company=google . [G] - [657] J. Bausch et al., “Learning high-accuracy error decoding for quantum processors,” Nature, vol. 635, no. 8040, pp. 834–840, Nov. 2024, doi: 10.1038/s41586-024-08148-8. [D]
- [658] Riverlane, “Riverlane publishes QEC Technology Roadmap that can accelerate quantum computing's path to utility scale by 3–5 years,” Mar. 12, 2026. [Online]. Available: https://www.riverlane.com/
press-release/ [R]riverlane-publishes-qec-technology-roadmap - [659] Qblox; Riverlane, “Qblox and Riverlane Demonstrate Integration Enabling Real-Time Quantum Error Correction,” PR Newswire, Mar. 17, 2026. [Online]. Available: https://www.prnewswire.com/
news-releases/ [C]qblox-and-riverlane-demonstrate-integration-enabling-real-time-quantum-error-correction-302716254.html - [661] Riverlane, “Riverlane raises $75 million to meet surging global demand for quantum error correction technology,” Aug. 6, 2024. [Online]. Available: https://www.riverlane.com/
press-release/ [C]riverlane-raises-75-million-to-meet-surging-global-demand-for-quantum-error-correction-technology - [662] A. B. Ziad, A. Zalawadiya, B. Barber, and L. Skoric, “Quantum decoder,” Google Patents, Dec. 10, 2025. [Online]. Available: https://patents.google.com/
patent/ [G]GB2641501A/ en - [729] X. Yang et al., “Real-time Surface-Code Error Correction Using an FPGA-based Neural-Network Decoder,” arXiv:2605.04892, May 2026. Also https://arxiv.org/
html/ . [D]2605.04892 - [731] Google DeepMind and Google Quantum AI, “AlphaQubit tackles one of quantum computing's biggest challenges,” Google The Keyword, Nov. 20, 2024. [Online]. Available: https://blog.google/
innovation-and-ai/ [C]models-and-research/ google-deepmind/ alphaqubit-quantum-error-correction/ - [732] C. Lee, T. Hur, and D. K. Park, “Scalable Neural Decoders for Practical Real-Time Quantum Error Correction,” arXiv:2510.22724, Oct. 2025. [S]
- [733] A. Knapen et al., “Pinball: A Cryogenic Predecoder for Surface Code Decoding Under Circuit-Level Noise,” arXiv:2512.09807, Dec. 2025. [S]